
KajoData / SQL
Nauka SQL: plan od SELECT do samodzielnej analizy
Pokazuję kolejność nauki i zadania sprawdzające rozumienie. Przy każdym kroku pilnuję znaczenia wiersza, braków danych i liczby dopasowań.
Dobry plan nauki SQL powinien prowadzić do samodzielnej odpowiedzi na pytanie o dane. Sama lista słów kluczowych tego nie zapewnia. Możesz znać JOIN, GROUP BY i CTE, a mimo to policzyć jedno zamówienie trzy razy. Dlatego układam naukę wokół kolejnych pytań i kontroli wyniku. Każdy etap ma małe zadanie, które pokazuje, czy rozumiesz użyte narzędzie.
Poniżej dostajesz plan dla osoby idącej w analizę danych. Zaczynam od odczytu i filtrowania, potem przechodzę do agregacji, łączenia tabel, dzielenia problemu na kroki i funkcji okienkowych. Przykłady zapisuję dla PostgreSQL. Dokumentację sprawdziłem przy redakcji w listopadzie 2026; konkretne zachowania innych silników trzeba potwierdzić osobno.
Najpierw poznaj środowisko i znaczenie wiersza
SQL to język, silnik bazy wykonuje zapytanie, a klient pozwala je wpisać i obejrzeć odpowiedź. Możesz rozpocząć w środowisku przeglądarkowym albo we własnej bazie. Instalacja lokalna jest przydatną umiejętnością, ale nie musi blokować pierwszej lekcji. Ważne, żebyś wiedział, do jakiego silnika się łączysz i gdzie znajdują się dane ćwiczeniowe.
Nie mieszaj od razu przykładów z PostgreSQL, MySQL i SQL Server. Wspólne podstawy są duże, ale różnią się funkcje dat, ograniczanie wyniku i część składni. Gdy przepisane zapytanie nie działa, sprawdź dialekt przed szukaniem literówki. W notatkach zapisuj nazwę silnika razem z przykładem, szczególnie przy rozwiązaniu znalezionym w internecie.
Do całego planu wystarczą dwie małe, syntetyczne tabele. W customers każdy wiersz oznacza jednego klienta, a customer_id jest unikalny. W orders jeden wiersz oznacza zamówienie; order_id jest unikalny. Kwoty są umownymi liczbami w jednej jednostce, bez podatków i zwrotów.
| customer_id | customer_name |
|---|---|
| 1 | Ada |
| 2 | Ben |
| 3 | Celina |
| order_id | customer_id | amount | status |
|---|---|---|---|
| 101 | 1 | 100 | completed |
| 102 | 1 | 50 | cancelled |
| 103 | 2 | 80 | completed |
| 104 | 2 | NULL | pending |
NULL w ostatnim zamówieniu oznacza brak znanej kwoty. Nie zastępuję go na starcie zerem. Ada ma dwa zamówienia, Ben dwa, Celina żadnego. Suma znanych kwot wynosi 230, a suma kwot zamówień completed wynosi 180. Zachowaj te liczby obok ćwiczenia, żeby móc wracać do znaczenia wyniku.
Etap pierwszy: SELECT, kolumny i porządek
Zacznij od wskazania potrzebnych kolumn i czytelnych aliasów. Wprowadzenie PostgreSQL do SELECT pokazuje wybór pól, wyrażenia oraz filtrowanie. Na naszych danych pierwsze zadanie może wyglądać tak:
SELECT order_id, amount AS order_amount
FROM orders
ORDER BY order_id;
Dostajesz cztery wiersze w kolejności identyfikatorów. Alias zmienia nazwę kolumny wyniku, nie nazwę pola w źródłowej tabeli. SELECT * pomaga obejrzeć nieznaną tabelę, ale w raporcie wolę wypisać potrzebne kolumny. Wtedy czytelnik widzi od razu, jakie informacje wybieram i z czego korzysta dalsza część zapytania.
Naucz się odróżniać wybór rekordów od kolejności ich prezentacji. Chcesz dwa zamówienia o najmniejszych identyfikatorach? Dopisz LIMIT 2 po sortowaniu. Dokumentacja LIMIT podkreśla konieczność jednoznacznego porządku, jeśli zależy Ci na przewidywalnym podzbiorze. Samo „pierwsze dwa” bez ustalonej kolejności nie opisuje wyniku wystarczająco dokładnie.
Sprawdzian jest prosty: potrafisz przewidzieć liczbę wierszy, nazwy kolumn i sposób uporządkowania. Przenieś amount przed order_id i zobacz, że znaczenie danych pozostaje to samo. Dopiero po oswojeniu wyniku dodawaj nowe warunki. Jeden nowy pomysł na zapytanie pozwala łatwiej zauważyć, skąd bierze się zmiana.
Etap drugi: WHERE, logika i brak danych
Wybierz ukończone zamówienia za co najmniej 90:
SELECT order_id, amount
FROM orders
WHERE status = 'completed'
  AND amount >= 90
ORDER BY order_id;
Zostaje zamówienie 101 z kwotą 100. Status eliminuje 102, próg eliminuje 103. Zmieniaj osobno każdy warunek i sprawdzaj, które rekordy wracają. Przy łączeniu AND z OR dodawaj nawiasy zgodne z zamiarem. Możesz też zapisać regułę po polsku przed przepisaniem jej do SQL.
Dla brakującej kwoty użyj amount IS NULL. Warunek amount = NULL nie służy do wyszukiwania braków. Dokumentacja porównań PostgreSQL wyjaśnia, że zwykłe porównanie z NULL daje nieznany wynik. W naszym przykładzie osobne zapytanie o brak kwoty powinno wskazać zamówienie 104.
Kiedy dołożysz daty, świadomie ustal granice okresu. Dla znacznika czasu wygodną regułą bywa początek włącznie i początek następnego okresu wyłącznie. Zapisz też przyjętą strefę czasową. Nie wystarczy nazwać filtra „listopad”, jeśli źródło przechowuje momenty w innej strefie, a odbiorca rozlicza lokalne dni.
Etap kończę, kiedy umiesz wyjaśnić każdy odrzucony wiersz. Pusty wynik nie musi oznaczać braku danych w źródle. Może wynikać z błędnego warunku, różnicy typów albo innego zapisu statusu. Zmniejszaj zapytanie do jednego kryterium, zamiast od razu dopisywać kolejne funkcje.
Etap trzeci: agregaty, GROUP BY i HAVING
Najpierw policz osobno liczbę zamówień i liczbę znanych kwot:
SELECT COUNT(*) AS orders_count,
       COUNT(amount) AS known_amounts,
       SUM(amount) AS total_amount,
       AVG(amount) AS average_amount
FROM orders;
Wyniki to odpowiednio 4, 3, 230 oraz średnia 230 podzielone przez 3. Lista agregatów PostgreSQL rozróżnia liczenie wszystkich wierszy od liczenia niepustych wartości. Do średniej używamy AVG, a nie nazw MEAN czy AVERAGE przeniesionych z innych narzędzi.
Następnie policz kwotę completed dla każdego klienta i pozostaw tylko grupy z sumą ponad 90:
SELECT customer_id, SUM(amount) AS completed_amount
FROM orders
WHERE status = 'completed'
GROUP BY customer_id
HAVING SUM(amount) > 90
ORDER BY customer_id;
Pozostaje klient 1 z kwotą 100. WHERE wybiera zamówienia przed grupowaniem, HAVING ocenia gotowe grupy. Ten podział opisuje rozdział o agregacji. Dla zrozumienia spróbuj najpierw opowiedzieć, jakie dwa wiersze wejdą do grupowania, a dopiero potem ocenić ich sumy.
Za każdym razem określ jednostkę wyniku. Po GROUP BY customer_id jeden wiersz oznacza klienta z grupy, nie pojedyncze zamówienie. Jeżeli następny etap łączy to podsumowanie z pozycjami zamówień, liczby mogą się powielić. Zapisanie poziomu szczegółowości przy każdym kroku jest jedną z najbardziej użytecznych notatek początkującego analityka.
Etap czwarty: JOIN i liczba dopasowań
Teraz chcę zobaczyć wszystkich klientów razem z zamówieniami:
SELECT c.customer_id, c.customer_name, o.order_id
FROM customers AS c
LEFT JOIN orders AS o
  ON o.customer_id = c.customer_id
ORDER BY c.customer_id, o.order_id;
Ada zajmuje dwa wiersze, Ben dwa, Celina jeden z NULL po stronie zamówienia. Łącznie wynik ma pięć wierszy. LEFT JOIN zachowuje klienta bez dopasowania, ale nie obiecuje jednego rekordu na klienta. Opis złączeń PostgreSQL tłumaczy dopasowywanie par i zachowanie wierszy przy złączeniu zewnętrznym.
Porównaj wynik z INNER JOIN. Celina zniknie, a pozostaną cztery dopasowane zamówienia. Dopiero potem przejdź do innych typów złączeń. Ja wolę dobrze rozumieć te dwa przypadki niż odtwarzać z pamięci wszystkie diagramy. Przeczytaj też poradnik LEFT JOIN, zwłaszcza przed filtrowaniem prawej tabeli.
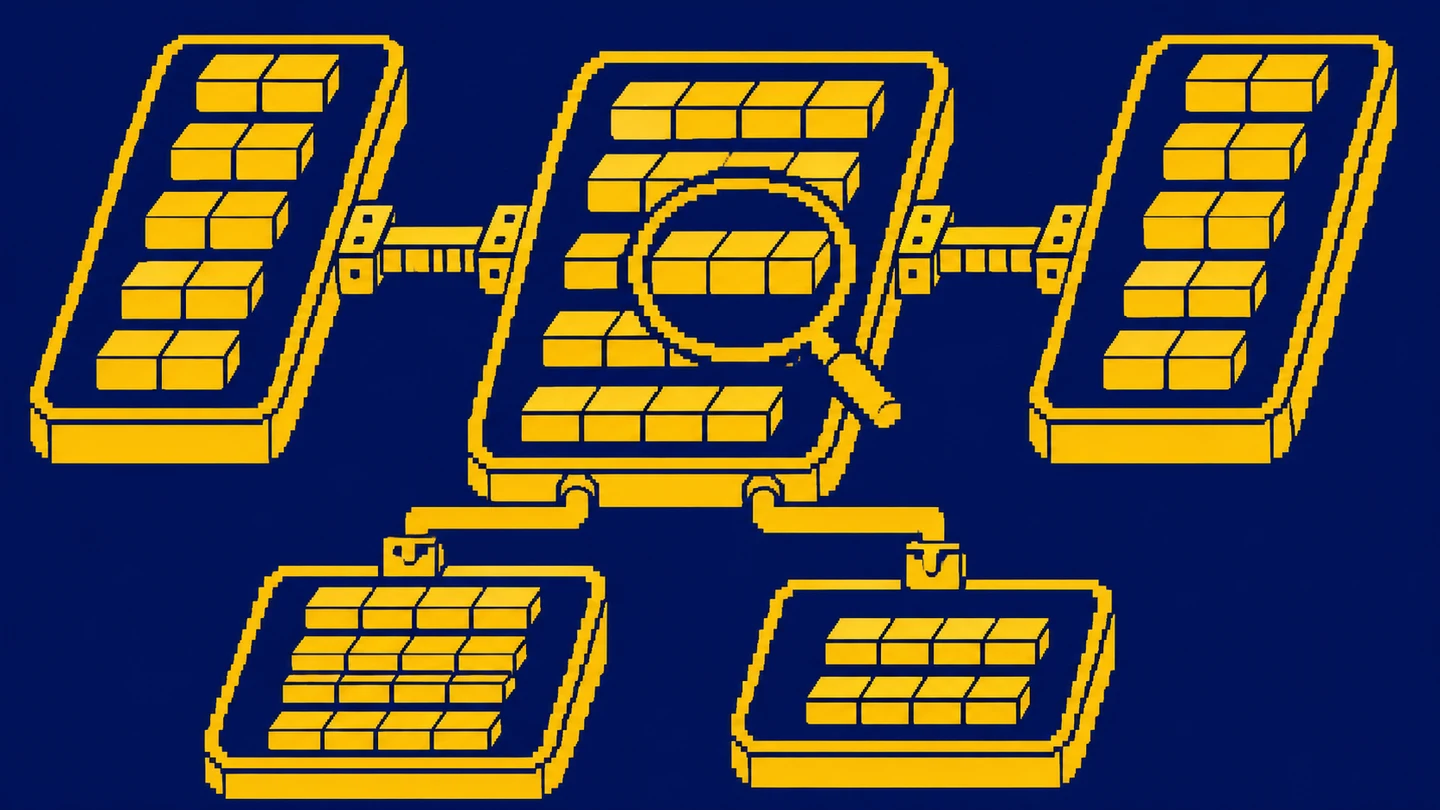
W ramach ćwiczenia wyobraź sobie drugi wpis klienta 1 w słowniku. Każde jego zamówienie dostanie kolejne dopasowanie. Nie naprawiaj takiego problemu automatycznie DISTINCT. Najpierw ustal, dlaczego klucz przestał być unikalny i który rekord powinien obowiązywać. Usunięcie podobnych wierszy może zamaskować błąd albo usunąć legalne dane.
Etap piąty: podzapytania i CTE
Gdy pytanie wymaga kilku kroków, nazwij je. Na przykład najpierw policz ukończoną sprzedaż na klienta, a potem wybierz wyniki powyżej progu:
WITH completed_totals AS (
    SELECT customer_id, SUM(amount) AS total_amount
    FROM orders
    WHERE status = 'completed'
    GROUP BY customer_id
)
SELECT customer_id, total_amount
FROM completed_totals
WHERE total_amount > 90
ORDER BY customer_id;
Otrzymasz ten sam wynik co wcześniej: klient 1 i kwota 100. Zysk w tym ćwiczeniu polega na czytelnym nazwaniu etapu. Dokumentacja WITH opisuje także zasady materializacji. CTE nie daje ogólnej gwarancji zapisania wyniku ani przyspieszenia zapytania.
Podzapytanie i CTE poznawaj jako sposoby organizowania problemu. W notatkach dopisz, co jest wejściem i wyjściem danego kroku. Jeśli podzapytanie ma dać jedną kwotę, zastanów się, co się stanie, kiedy zwróci wiele wierszy. Jeśli ma dać listę klientów, sprawdź, czy nie zawiera duplikatów istotnych dla późniejszego połączenia.
Na początek nie potrzebujesz rekurencji ani najbardziej skróconego zapisu. Potrzebujesz umieć wrócić do zapytania po tygodniu i powiedzieć, dlaczego każda część tam jest. Nazwa completed_totals pomaga bardziej niż cte1, bo przypomina zarówno filtr statusu, jak i agregację.
Etap szósty: funkcje okienkowe
Okna przydają się, gdy chcesz zachować zamówienia i dopisać obok podsumowanie klienta:
SELECT order_id, customer_id, amount,
       SUM(amount) OVER (PARTITION BY customer_id) AS customer_amount
FROM orders
ORDER BY order_id;
Dla zamówień 101 i 102 zobaczysz obok sumę 150, a dla 103 i 104 sumę 80. Nadal masz cztery wiersze. Wprowadzenie do funkcji okienkowych wyjaśnia zachowanie tożsamości wierszy podczas obliczeń na powiązanym zbiorze. Tutaj nie dodaję ORDER BY wewnątrz OVER, żeby nie wprowadzać jeszcze sumy narastającej i ramki.
Następnie wybierz osobny temat: ranking, poprzednią wartość albo sumę narastającą. Ustal regułę remisów i brakujących okresów. „Poprzedni wiersz” może oznaczać poprzednie zamówienie, ale niekoniecznie poprzedni dzień kalendarzowy. Takie rozróżnienie powinno wynikać z pytania, zanim dobierzesz funkcję.
Nie traktuję okien jako obowiązkowego warunku rozpoczęcia pierwszego projektu. Umiejętność poprawnego filtrowania, grupowania i łączenia tabel już pozwala zrobić użyteczną analizę. Okna dokładaj wtedy, kiedy potrafisz porównać ich wynik z prostszym podsumowaniem i wyjaśnić różnicę w liczbie wierszy.
Zmiana danych oraz czytanie planu
Analityk powinien rozpoznawać także operacje zmieniające dane. INSERT dodaje wiersze, UPDATE aktualizuje wartości, DELETE usuwa wybrane wiersze, a CREATE i DROP dotyczą obiektów. Ćwicz je w wydzielonej bazie treningowej. Rozdział PostgreSQL o UPDATE pokazuje wybór rekordów warunkiem; brak właściwego warunku może rozszerzyć zmianę na całą tabelę.
W planie nauki zostawiłbym na to osobny etap, bez mieszania modyfikacji z raportem dla odbiorcy. Ucząc się odczytu, możesz skupić się na znaczeniu wyniku. Przy modyfikacji musisz dodatkowo rozumieć skutek dla źródła. To inny rodzaj odpowiedzialności, więc warto pracować na danych, które łatwo odtworzyć.
Do wydajności przejdź z zapytaniem, które najpierw daje właściwą odpowiedź. EXPLAIN pokazuje plan wykonania, a EXPLAIN ANALYZE rzeczywiście wykonuje polecenie i zbiera pomiary, co wyjaśnia dokumentacja. Na początku ucz się rozpoznawać liczbę wierszy i miejsca kosztownych operacji. Nie zakładaj, że każdy indeks pomoże lub że krótszy SQL będzie szybszy.
Jak wybrać kurs i sprawdzić samodzielność
Zajrzyj do programu kursu, ale obejrzyj również zadania. Potrzebujesz ćwiczeń, w których sam wybierasz filtr, klucz połączenia i poziom grupowania. Materiał prowadzony klik po kliku jest dobry na pierwszy kontakt. Później powinien pojawić się moment, kiedy masz tylko dane, pytanie i konieczność uzasadnienia odpowiedzi.
Sprawdź, czy kurs nazywa silnik i wersję, omawia NULL oraz pokazuje błędy liczności po JOIN. Sama długość nagrań niewiele mówi o tym, ile samodzielnie napiszesz. Warto też zobaczyć, czy rozwiązanie zawiera komentarz do wyniku. Zapytanie bez interpretacji łatwo skopiować, ale trudno ocenić w nowym kontekście.
Projekt końcowy może być mały. Odpowiedz, którzy klienci złożyli ukończone zamówienia, ile wynosi ich kwota i kto jeszcze nie kupił. Przy każdym wyniku podaj jednostkę wiersza, regułę braków i oczekiwaną liczbę rekordów. Potem zmień jedną daną: dopisz klienta bez zamówienia albo zamówienie anulowane. Przewidź, która odpowiedź powinna się zmienić.
Jeżeli utkniesz, zapisz oczekiwanie i to, co rzeczywiście widzisz. Pięć wierszy zamiast trzech może być całkowicie poprawnym skutkiem relacji jeden do wielu. Wyszukanie błędu zaczyna się od nazwania tej różnicy. Pomoże Ci też tekst o logicznej kolejności klauzul, gdy nie wiesz, na którym etapie znika rekord.
Dokumentacja pozostaje dozwolona podczas całej nauki. W pracy również sprawdza się składnię. Najważniejsze, żebyś potrafił wybrać rozwiązanie, opisać jego ograniczenia i zauważyć wynik, który nie zgadza się z danymi. Wtedy plan kursu staje się mapą konkretnych umiejętności, do której możesz wrócić przy następnym projekcie.
Co robić, gdy zapytanie działa, a odpowiedź wygląda dziwnie
Komunikat o poprawnym wykonaniu mówi, że silnik przyjął polecenie. Nadal możesz mieć niewłaściwy status, zły okres albo złączenie po nazwie zamiast po identyfikatorze. Wtedy wracam do najmniejszego przykładu. Wypisuję identyfikatory zamówień, które powinny wejść do wyniku, i sprawdzam je przed agregacją. Łatwiej wyjaśnić cztery rekordy niż jedną sumę, w której ukryło się kilka niezależnych problemów.
Załóżmy, że przy zadaniu o ukończonych zamówieniach wyszło Ci 230. Taka liczba ma sens w źródle, ale obejmuje również anulowane zamówienie za 50. Nie zaczynaj od zmiany SUM na inną funkcję. Sprawdź, czy warunek completed rzeczywiście działa w miejscu, w którym liczysz kwotę. Wartość wiarygodna na pierwszy rzut oka bywa trudniejsza do wykrycia niż zwykły błąd składni.
Drugi przypadek to klient bez zakupów. Jeżeli pytanie dotyczy wszystkich klientów, Celina powinna znaleźć się w odpowiedzi. Jeśli zaczynasz od tabeli zamówień, nie ma tam żadnego jej rekordu. Właściwe źródło wynika więc z zakresu pytania. Przed pisaniem JOIN zadaj sobie pytanie, którą grupę osób albo obiektów obiecałeś pokazać odbiorcy. Tę decyzję warto opisać w komentarzu przy raporcie.
Przy liczbach powtarzających się po połączeniu prześledź jeden klucz. Wybierz Adę, obejrzyj jej dwa zamówienia i porównaj je z danymi słownika. Jeśli rozumiesz każde dopasowanie tej jednej osoby, łatwiej ocenisz całą relację. Nie potrzebujesz do tego od razu ogromnego diagramu. Potrzebujesz jawnej odpowiedzi, ile rekordów po obu stronach może mieć ten sam klucz.
Mały rytm ćwiczeń na kolejne sesje
Na pierwszą sesję wybierz odczyt czterech zamówień i dwa różne filtry. Na następną przygotuj podsumowanie klienta oraz wyjaśnienie brakującej kwoty. Potem dodaj listę wszystkich klientów i sprawdź, gdzie trafia osoba bez zakupów. Czas sesji dobierz do swoich możliwości. Zakończ ją wtedy, gdy umiesz powtórzyć zadanie z małą zmianą danych, zamiast tylko obejrzeć rozwiązanie.
Zachowuj pytanie obok zapytania. Dopisz, co oznacza amount, które statusy wchodzą do wyniku i czy klient bez zamówień powinien być widoczny. Przy ponownym otwarciu ćwiczenia te założenia szybko znikają z pamięci. Bez nich nawet dobrze napisany SQL wymaga odgadywania intencji autora, a Ty uczysz się raczej własnych dawnych skrótów myślowych niż analizy.
Co kilka sesji wróć do wcześniejszego pytania i rozwiąż je od początku. Porównaj podejście, ale nie oceniaj postępu wyłącznie liczbą znaków. Dłuższe zapytanie z jasnymi etapami może być łatwiejsze do sprawdzenia. Spróbuj też opowiedzieć wynik osobie, która nie zna SQL. Jeżeli potrafisz pokazać, skąd wzięło się 180, i wskazać, czego ta liczba nie obejmuje, robisz użyteczny krok w stronę pracy analitycznej.
Najważniejsze w pigułce
Czy muszę od razu instalować bazę lokalnie?
Nie. Możesz zacząć w środowisku przeglądarkowym, ale ustal silnik i później poznaj sposób łączenia z własną bazą.
Jak nazywa się funkcja średniej?
W pokazanym PostgreSQL jest to AVG. MEAN i AVERAGE nie są nazwami użytej tu funkcji agregującej.
Czy CTE automatycznie przyspiesza zapytanie?
Nie. Pomaga nazwać kroki; sposób wykonania i materializacji zależy od zapytania oraz silnika.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
