
KajoData / SQL
WHERE w SQL: filtry, NULL i granice dat
Wybieram październikowe zamówienia z sześciu rekordów. Pokazuję, jak nawiasy, brak statusu i koniec miesiąca zmieniają wynik.
Najbardziej podstępny błąd w WHERE to taki, po którym zapytanie działa. Dostajesz liczby, wykres wygląda rozsądnie, tylko raport obejmuje inny zbiór zamówień, niż zakładałeś. Ja dlatego zaczynam filtrowanie od zdania po polsku: które rekordy mają zostać i dlaczego?
W tym poradniku wybiorę polskie zamówienia z października, mające dopuszczalny status i dodatnią kwotę. Przy okazji pokażę, gdzie gubią się końcówki dni, jak nawiasy zmieniają warunek i co robi NULL. Przykłady dotyczą PostgreSQL 18 i sześciu syntetycznych rekordów, które można przejrzeć bez kalkulatora.
Co WHERE robi z wierszem
WHERE sprawdza warunek dla danych wejściowych zapytania. Dalej przechodzą wiersze, dla których warunek ma wartość prawda. Fałsz oraz wynik nieznany nie przechodzą. Tę regułę opisuje dokumentacja wyrażeń tabelowych.
Lista SELECT wybiera kolumny widoczne w wyniku. WHERE wybiera rekordy, które w ogóle do tego wyniku trafią. Mogę filtrować po kraju, nie pokazując kraju w tabeli końcowej. Warunek musi mieć dostęp do pola w swoim źródle, ale nie musi wyświetlać go odbiorcy.
W zapisie zapytania WHERE znajduje się po FROM i ewentualnych JOIN, przed GROUP BY, HAVING i ORDER BY. To opis struktury oraz logicznego znaczenia. Fizyczny sposób odczytu danych wybiera silnik. Nie wyprowadzam z kolejności zapisanych warunków obietnicy, w jakiej kolejności baza wykona poszczególne operacje.
Sześć zamówień i konkretne pytanie
Przyjmuję następujące dane. Jeden rekord oznacza jedno zamówienie, kwota jest umowna, a created_at ma typ timestamp bez strefy czasowej. W tym przykładzie wszystkie chwile interpretujemy według tego samego lokalnego zegara.
| order_id | created_at | status |
|---|---|---|
| 1 | 2026-10-01 09:00:00 | ready |
| 2 | 2026-10-31 18:00:00 | shipped |
| 3 | 2026-11-01 00:00:00 | ready |
| 4 | 2026-10-15 10:00:00 | cancelled |
| 5 | 2026-10-20 12:00:00 | NULL |
| 6 | 2026-10-22 08:00:00 | shipped |
Kraj i kwota tych samych sześciu zamówień są poniżej. To dalsze kolumny jednego źródła, rozdzielone dla czytelności.
| order_id | country | amount |
|---|---|---|
| 1 | PL | 100 |
| 2 | PL | 50 |
| 3 | PL | 80 |
| 4 | DE | 200 |
| 5 | PL | 0 |
| 6 | DE | NULL |
Pytanie brzmi: które zamówienia z PL utworzono w październiku 2026, mają status ready albo shipped i kwotę większą od zera? Oczekuję rekordów 1 i 2. Każdy pozostały odpada z konkretnego powodu: listopadowa data, inny kraj, brak dopuszczalnego statusu lub niewłaściwa kwota.
Poniższy kod tworzy źródło tylko dla jednej instrukcji. W dalszych przykładach zachowaj fragment WITH, a następnie wymień SELECT. VALUES służy tu wyłącznie do podania małych danych przykładowych.
WITH orders(order_id, created_at, status, country, amount) AS (
    VALUES
        (1, TIMESTAMP '2026-10-01 09:00:00', 'ready', 'PL', 100),
        (2, TIMESTAMP '2026-10-31 18:00:00', 'shipped', 'PL', 50),
        (3, TIMESTAMP '2026-11-01 00:00:00', 'ready', 'PL', 80),
        (4, TIMESTAMP '2026-10-15 10:00:00', 'cancelled', 'DE', 200),
        (5, TIMESTAMP '2026-10-20 12:00:00', NULL, 'PL', 0),
        (6, TIMESTAMP '2026-10-22 08:00:00', 'shipped', 'DE', NULL)
)
SELECT order_id, amount
FROM orders
WHERE country = 'PL'
  AND created_at >= TIMESTAMP '2026-10-01 00:00:00'
  AND created_at < TIMESTAMP '2026-11-01 00:00:00'
  AND status IN ('ready', 'shipped')
  AND amount > 0
ORDER BY order_id;| order_id | amount |
|---|---|
| 1 | 100 |
| 2 | 50 |
Porównania liczb i tekstu
Równość zapisuję jako =, nierówność jako <>. Operatory >, >=, < i <= pozwalają ustalić granice. Dokumentacja porównań opisuje ich działanie, także dla typów innych niż liczby. U nas amount >= 100 przepuszcza zamówienia 1 i 4, natomiast amount > 100 tylko zamówienie 4.
Wartość tekstową otaczam apostrofami: country = 'PL'. Liczbę w tym przykładzie zapisuję bez apostrofów. Nie chcę polegać na przypadkowej konwersji tekstu na liczbę. Jeżeli import umieścił kwoty w kolumnie tekstowej, najpierw potrzebuję ustalić format i sposób przygotowania danych.
Dla dokładnie określonego kodu kraju wybieram równość. Nazwa pola również wymaga definicji: kraj dostawy, kraj klienta i kraj wystawienia dokumentu mogą się różnić. Żaden operator nie rozstrzygnie tego za mnie. W syntetycznej tabeli przyjmuję jeden ustalony kod, ale w raporcie firmowym zapisałbym, do którego zdarzenia się odnosi.
Nie wyciągam też uniwersalnych reguł o wielkości liter z jednego udanego porównania. Zachowanie tekstu zależy między innymi od konfiguracji porównywania. Jeśli źródło miesza PL, pl i dodatkowe spacje, trzeba ustalić zasady normalizacji zamiast zakładać, że każdy silnik potraktuje te wartości identycznie.
AND, OR i nawiasy
AND wymaga spełnienia obu warunków, OR dopuszcza spełnienie przynajmniej jednego. W PostgreSQL AND wiąże silniej niż OR; kolejność operatorów opisuje struktura leksykalna SQL. Gdy mieszam te operatory, jawne nawiasy pomagają sprawdzić intencję.
SELECT order_id
FROM orders
WHERE country = 'PL'
  AND (status = 'ready' OR status = 'shipped')
ORDER BY order_id;
Wynik to 1, 2 i 3. W tym zapytaniu celowo pomijam datę i kwotę, żeby odizolować regułę statusu. Każdy wynikowy rekord musi dotyczyć PL i jednego z dwóch statusów.
Jeśli usunę nawiasy, warunek zostanie odczytany jako (country = 'PL' AND status = 'ready') OR status = 'shipped'. Dojdzie zamówienie 6, bo shipped wystarczy wtedy niezależnie od kraju. Baza nie zgłosi błędu składni. Dostała poprawne polecenie opisujące inny zbiór.
Ja przy przeglądzie takiego filtra szukam przede wszystkim alternatywy, która może ominąć warunek obowiązkowy. Kraj, miesiąc albo typ dokumentu często mają obowiązywać we wszystkich gałęziach. Jedna dopisana linia OR potrafi przypadkiem poszerzyć raport o dane spoza tych granic.
IN upraszcza listę dopuszczalnych wartości
Dla dwóch statusów mogę zapisać status IN ('ready', 'shipped'). W naszym przykładzie zastępuje to nawias z dwiema równościami połączonymi OR. Łatwiej wtedy zobaczyć, że lista należy do jednego pola. Przy większej liczbie statusów kod pozostaje czytelny.
Lista IN nie jest wzorcem tekstowym. Wartość 'ship' nie dopasuje automatycznie 'shipped'. Jeżeli biznes dodaje nowy status, trzeba zdecydować, czy należy do raportu, a następnie świadomie zmienić listę. Samo podobieństwo nazw nie ustanawia wspólnej definicji.
Osobno traktuję NOT IN i NULL. Jeśli lista wykluczeń zawiera NULL, brak dopasowania do pozostałych wartości może dać wynik nieznany. Dokumentacja IN i NOT IN opisuje tę pułapkę. Nie dodaję NULL do listy w nadziei, że oznacza „także brak statusu”. Do braków używam jawnego IS NULL.
NULL nie oznacza fałszu ani zera
Warunek status = NULL nie znajduje brakujących statusów. Poprawny zapis to status IS NULL; w naszych danych wskazuje zamówienie 5. Dla znanych wartości mogę użyć IS NOT NULL. Zasady tych predykatów są opisane w dokumentacji porównań.
SQL stosuje logikę z wynikiem nieznanym. Porównanie brakującej kwoty z zerem nie daje prawdy, dlatego zamówienie 6 nie przejdzie warunku amount > 0. Ale nie przejdzie także amount <= 0. Brakująca wartość nie należy automatycznie do jednej z dwóch liczbowych kategorii.
To ma znaczenie przy opisywaniu raportu. Jeżeli wybierzesz „wszystkie zamówienia inne niż anulowane” przez status <> 'cancelled', rekord 5 również zniknie. Nie wiadomo przecież, czy jego brakujący status różni się od cancelled. Jeśli biznes chce włączyć braki, zapisz (status <> 'cancelled' OR status IS NULL) i opisz taką decyzję.
Tablice operatorów logicznych pokazują również, że prawda OR nieznane daje prawdę, a fałsz AND nieznane daje fałsz. Sam NULL w jednym fragmencie nie przesądza więc o całym warunku. Warto prześledzić kompletne wyrażenie, szczególnie gdy filtr ma kilka gałęzi.
Miesiąc zapisuję jako przedział z otwartym końcem
W głównym zapytaniu początek października jest włączony, a początek listopada wyłączony. Dzięki temu zamówienie 2 z godziny osiemnastej ostatniego dnia miesiąca zostaje. Zamówienie 3 z dokładnej północy kolejnego miesiąca odpada. Nie muszę zgadywać ostatniego ułamka sekundy października.
BETWEEN obejmuje obie granice. Dla kolumny timestamp zapis pomiędzy północą 1 października a północą 31 października nie obejmie całego ostatniego dnia. To częsty powód zaniżonego wyniku. Sama data w opisie wymagania nie wystarcza do ustalenia, jak mają być traktowane godziny.
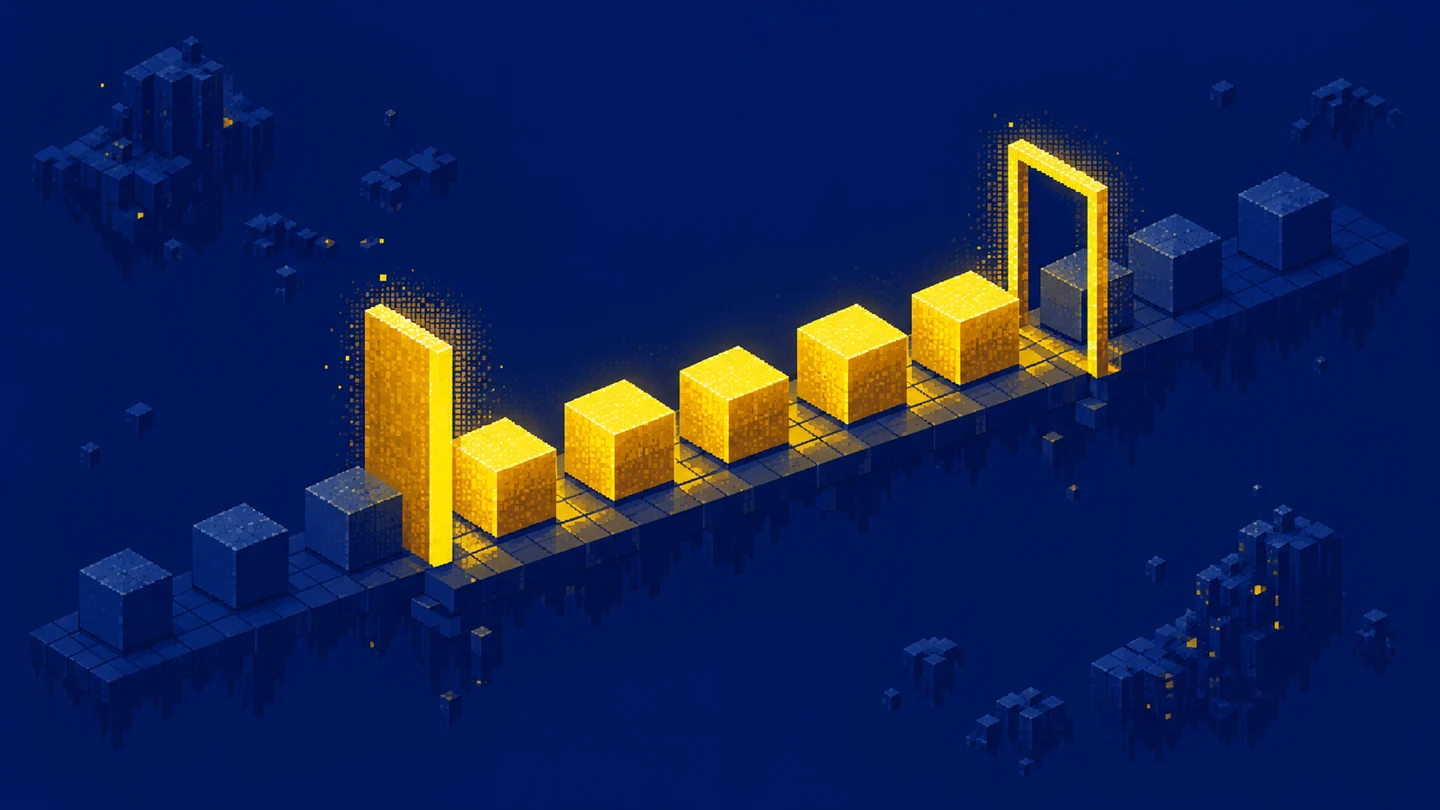
Przedział >= początek i < następny_początek łatwo składać w kolejne miesiące bez wspólnej granicy liczonej dwukrotnie. Styczeń kończy się tam, gdzie luty się zaczyna, ale tylko jeden z tych filtrów obejmuje chwilę graniczną. To przydatne przy porównywaniu sąsiednich okresów.
W tym tekście używam timestamp bez strefy. Jeśli prawdziwe zdarzenia są zapisane jako timestamptz, trzeba określić strefę raportowania i odpowiadające jej chwile graniczne. Dokumentacja dat i czasu rozróżnia te typy. Nie przenoszę naszego lokalnego przykładu wprost na globalny system zdarzeń.
LIKE służy do wzorca
Zapis status LIKE 'ship%' w naszym zbiorze pasuje do shipped, więc zwróci zamówienia 2 i 6. Znak procentu oznacza dowolny ciąg znaków, a podkreślenie pojedynczy znak. Dokumentacja dopasowania wzorców opisuje również uciekanie znaków specjalnych.
Do zamkniętej listy statusów pozostaję przy IN. LIKE przydaje się, gdy wymaganie rzeczywiście dotyczy wzorca. Jeśli potrzebuję dosłownego podkreślenia w kodzie produktu, muszę uwzględnić jego specjalne znaczenie. Kopiowanie fragmentu nazwy do wzorca bez tej refleksji może wybrać więcej rekordów niż planowano.
Nie przypisuję LIKE składni wyrażeń regularnych. Nawiasy kwadratowe nie stanowią tutaj uniwersalnego sposobu zapisania zestawu liter. Rozszerzenia różnych silników trzeba sprawdzać oddzielnie. W tym poradniku wystarczają dwa proste symbole i jednoznaczne odwołanie do PostgreSQL.
WHERE a HAVING i aliasy
WHERE działa na wierszach przed grupowaniem. HAVING filtruje grupy. Jeśli pytam o pojedyncze zamówienia z dodatnią kwotą, używam WHERE. Jeśli o kraje, których suma zamówień przekracza ustalony próg, potrzebuję grupowania i warunku na agregacji. Te pytania dotyczą różnych poziomów danych.
Nie próbuję więc wpisywać SUM(amount) > 100 jako zwykłego warunku WHERE na tym samym poziomie. Najpierw trzeba ustalić, które rekordy składają się na sumę. Usunięcie części wierszy przed agregacją może zmienić wskaźnik, nawet jeżeli końcowy próg pozostaje taki sam.
Podobnie alias nadany dopiero w SELECT nie jest dostępny w WHERE tego samego zapytania. Jeśli obliczenie ma otrzymać nazwę i dopiero potem być filtrowane, mogę przygotować podzapytanie. Więcej o tych etapach znajdziesz w artykule o kolejności klauzul SQL i w haśle HAVING.
Sprawdzam granice oraz rekordy odrzucone
Główne wymaganie rozpisuję na proste pytania. PL pozostawia cztery rekordy. Ograniczenie do października pozostawia z nich trzy: 1, 2 i 5. Dopuszczalne statusy zostawiają 1 i 2. Dodatnia kwota nie zmienia już tego wyniku. Te liczby wynikają bezpośrednio z małej tabeli.
Potem szukam przykładu na granicy: dokładnie na początku okresu, dokładnie po jego końcu, równo na progu kwoty, z brakującym statusem. Zbiór złożony wyłącznie z oczywistych dopasowań nie pokazuje, czy dobrze zdefiniowano wykluczenia. Dwa zapytania mogą zwracać ten sam typowy przypadek i różnić się właśnie na granicy.
Przy dużej tabeli sam przegląd kilku pierwszych wyników nie daje pewności, że pozostałe są poprawne. Dlatego zachowuję krótką definicję zbioru oraz uzasadnienie wyjątków. Wtedy inna osoba może sprawdzić intencję bez odtwarzania całej rozmowy, która doprowadziła do powstania raportu.
Powody wykluczenia nie zawsze się sumują
Jedno zamówienie może jednocześnie należeć do innego kraju, mieć brakującą kwotę i niewłaściwy status. Jeśli osobno policzę każde naruszenie, suma takich liczników może przewyższyć liczbę odrzuconych rekordów. To nie dowodzi błędu w WHERE. Liczniki opisują wtedy nakładające się kategorie problemów.
Dlatego rozróżniam dwa sposoby opisu. Mogę pokazać wszystkie niespełnione warunki przy każdym rekordzie albo przypisać jeden główny powód według ustalonej kolejności. W drugim wariancie ta kolejność jest moją regułą raportowania. Nie oznacza fizycznej kolejności wykonania warunków przez silnik. Odbiorca powinien wiedzieć, który wariant widzi.
W naszym przykładzie zamówienie 5 ma zarazem brak statusu i kwotę zero. Po usunięciu filtra kwoty nadal nie przejdzie listy dopuszczalnych statusów. Sam wzrost liczby rekordów po poluzowaniu jednego warunku nie musi więc pokazać wszystkich rekordów, które tego warunku wcześniej nie spełniały. Inne ograniczenia nadal obowiązują.
Data utworzenia i moment odczytu statusu
Filtr październikowej daty utworzenia nie dowodzi, że pokazany status pochodzi z końca października. Źródło może przechowywać bieżący status zamówienia i aktualizować go w listopadzie. Wtedy raport opisze październikowe zamówienia według stanu dostępnego przy odczycie. To inne pytanie niż stan zamówień na zamknięcie miesiąca.
Jeśli potrzebuję takiego historycznego obrazu, muszę mieć odpowiednie dane: historię zmian albo uzgodniony zapis stanu. Samo dodanie kolejnego warunku WHERE nie odtworzy informacji, której nie zapisano. Przed publikacją ustalam więc osobno datę kwalifikującą zdarzenie i moment, którego dotyczą pozostałe atrybuty. Dzięki temu ponowne odczytanie raportu po tygodniu nie zaskakuje odbiorcy bez wyjaśnienia.
Warunek logiczny a szybkość zapytania
Nie zakładam, że przeniesienie warunku wyżej na liście AND sprawi, że baza wykona go jako pierwszy. PostgreSQL może zmieniać sposób oceny wyrażeń. Reguły ewaluacji wyjaśniają, dlaczego nie należy opierać poprawności na oczekiwanym wykonaniu od lewej do prawej.
Na przykład nie traktuję pierwszego warunku jako uniwersalnej ochrony przed błędem w następnym obliczeniu. Gdy dzielę przez pole, które może być zerem, potrzebuję wyrażenia poprawnego dla tej sytuacji, na przykład świadomie zastosowanego NULLIF. Samo ustawienie filtra przed dzieleniem w tekście zapytania nie stanowi takiej gwarancji.
Jeżeli zapytanie działa długo, analizuję plan, rozmiar danych i dostępne indeksy. EXPLAIN pomaga zobaczyć wybrany sposób wykonania. Nie obiecuję konkretnego przyspieszenia na podstawie sześciu rekordów. Najpierw ustalam poprawny zbiór, potem szukam wydajnego sposobu jego uzyskania.
Ćwiczenie: dopuść brak statusu świadomie
Zmień wymaganie: chcemy wszystkie październikowe zamówienia z PL ze statusem ready, shipped albo brakującym, niezależnie od kwoty. Usuń filtr kwoty i zastosuj (status IN ('ready', 'shipped') OR status IS NULL). Pozostaw kraj oraz obie granice czasu jako obowiązkowe warunki AND.
Oczekiwane identyfikatory to 1, 2 i 5. Zamówienie 3 nadal odpada przez listopadową datę, a zamówienia 4 i 6 przez kraj. Jeżeli otrzymasz więcej, sprawdź nawiasy. Jeżeli mniej, zobacz, czy próbujesz znaleźć NULL przez zwykłą równość albo czy pozostawiłeś filtr dodatniej kwoty.
Następnie opisz wynik jednym zdaniem dla odbiorcy raportu. Wspomnij, że braki statusu zostały świadomie włączone. Taka informacja ma znaczenie dla interpretacji liczby zamówień. Gotowe zapytanie powinno dawać się obronić zarówno w edytorze, jak i w rozmowie o tym, co właściwie zostało policzone.
Film o filtrowaniu w SQL
Zachowuję polski materiał o WHERE. Powyższy tekst rozwija temat na samodzielnych danych i nazywa dialekt każdego pokazanego przykładu.
Najważniejsze w pigułce
Czy WHERE wybiera kolumny?
WHERE wybiera wiersze spełniające warunek. Listę widocznych kolumn określa SELECT; pole użyte w filtrze nie musi być wyświetlane.
Jak znaleźć brakujące wartości?
Użyj IS NULL. Zwykłe porównanie z NULL daje wynik nieznany, który nie przechodzi przez WHERE.
Jak objąć cały miesiąc z godzinami?
W przykładzie timestamp stosuję początek miesiąca włącznie i początek następnego wyłącznie. Dla danych ze strefą trzeba również ustalić strefę raportowania.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
