
KajoData / Python
Wykres w Pythonie: Matplotlib, linie, punkty i histogram
Dobierz wykres do pytania, prześledź liczności histogramu i przygotuj plik z jednostkami oraz czytelnym opisem.
Wykres w Pythonie można zrobić kilkoma poleceniami. Trudniejsze pytanie brzmi: co ten wykres pozwoli powiedzieć o danych? Ja zaczynam od tego pytania, bo wygodnie jest narysować coś efektownego i dopiero później zauważyć brak jednostki, pomyloną kolejność punktów albo linię łączącą przypadkowe obserwacje.
Pokażę podstawy Matplotlib na małych danych syntetycznych. Przejdziemy przez wykres liniowy, punktowy i histogram, a potem opisy, skalę oraz eksport. Opieram składnię na dokumentacji Matplotlib 3.11. Przykłady są samodzielne: każdy zawiera import i dane, których potrzebuje. Ilustracje w artykule pokazują idee, nie są wynikami wykonania kodu.
Figure i Axes: porządek od pierwszego wykresu
Matplotlib ma interfejs oparty na funkcjach pyplot oraz styl, w którym jawnie pracujesz na obiektach. W oficjalnym wprowadzeniu znajdziesz oba. Tutaj wybieram zapis fig, ax = plt.subplots(), bo łatwo go rozwinąć, gdy potrzebujesz kolejnego panelu albo dwóch serii.
Figure to cała figura, którą możesz zapisać do pliku. Axes jest obszarem wykresu z danymi i osiami. Nazwa potrafi zmylić: Axes nie oznacza po prostu pojedynczej osi X. Dla jednego wykresu subplots() zwraca jedną figurę i jeden taki obszar.
import matplotlib.pyplot as plt

period = [1, 2, 3, 4]
orders = [10, 14, 12, 18]

fig, ax = plt.subplots(figsize=(8, 4), layout="constrained")
ax.plot(period, orders, marker="o")
ax.set(
    title="Zamówienia w czterech okresach: dane syntetyczne",
    xlabel="Okres",
    ylabel="Liczba zamówień",
)
ax.set_xticks(period)
plt.show()
Zakładam, że Matplotlib jest dostępny w środowisku, z którego uruchamiasz kod. Przy błędzie importu sprawdzam właśnie to środowisko. Notebook i terminal mogą korzystać z różnych interpreterów. Instalowanie biblioteki w przypadkowym terminalu nie daje pewności, że zobaczy ją otwarty notebook.
Parametr figsize określa rozmiar w calach. layout="constrained" pomaga zmieścić opisy w obrębie figury. To nadal wymaga obejrzenia wyniku: długi tytuł albo rozbudowana legenda potrafią zmienić czytelność całej kompozycji.
Kiedy linia ma sens
W przykładzie okresy są uporządkowane, a każda liczba oznacza zamówienia w kolejnym porównywalnym okresie. Linia pomaga śledzić zmianę: z 10 do 14, potem spadek do 12 i wzrost do 18. Znaczniki wskazują miejsca obserwacji.
Sama niewielka liczba punktów nie dyskwalifikuje wykresu liniowego. Cztery miesięczne obserwacje mogą tworzyć sensowny krótki szereg. Ważniejsze jest znaczenie połączenia: czy kolejność jest naturalna i czy odbiorca rozumie, że odcinek między pomiarami nie stanowi dodatkowego pomiaru?
Dokumentacja Axes.plot opisuje rysowanie linii i znaczników. Łączenie odbywa się w kolejności podanych punktów. Jeśli Twoje daty przyszły z eksportu w przypadkowej kolejności, zadbaj o ich uporządkowanie przed rysowaniem. Wykres nie ustala za Ciebie kolejności biznesowej.
Nie łączyłbym natomiast linią kolejnych klientów tylko dlatego, że mają identyfikatory od 1 do 100. Taki odcinek sugeruje ciągłość, która nie wynika z numeracji. Dla porównania kilku kategorii rozważyłbym słupki, a dla relacji dwóch zmiennych ilościowych wykres punktowy.
Scatter plot: jedna para wartości na obserwację
Weźmy cztery syntetyczne przesyłki. Chcę zobaczyć relację między masą a czasem pakowania. Każdy punkt reprezentuje jedną przesyłkę, bez łączenia jej z następną.
import matplotlib.pyplot as plt

weight_kg = [1, 2, 3, 4]
packing_minutes = [3, 4, 4, 7]

fig, ax = plt.subplots(figsize=(8, 4), layout="constrained")
ax.scatter(weight_kg, packing_minutes, s=60)
ax.set(
    title="Masa i czas pakowania: dane syntetyczne",
    xlabel="Masa przesyłki [kg]",
    ylabel="Czas pakowania [min]",
)
plt.show()
Widzę dwa czasy równe czterem minutom i najdłuższy czas przy największej masie. Na czterech wymyślonych obserwacjach pokazuję sposób odczytu, bez wniosku o całym magazynie. Sam układ punktów nie dowodzi też, że większa masa powoduje wolniejsze pakowanie. Mogą dochodzić wielkość pudełka, typ produktu czy doświadczenie osoby pakującej.
W Axes.scatter parametr s określa pole znacznika w punktach typograficznych do kwadratu. Dwukrotnie większe s nie oznacza dwukrotnie większej średnicy. Na początku zostawiam stałą wielkość punktów, żeby nie dokładać kolejnego kodowania danych bez potrzeby.
Przy wielu obserwacjach punkty mogą się nakładać. Wtedy mniejszy rozmiar i przezroczystość bywają pomocne, ale sama zmiana stylu nie powie, ile rekordów ukryło się pod jednym punktem. Rozkład i liczności trzeba sprawdzić także w danych.
Histogram pokazuje rozkład jednej zmiennej
Histogram odpowiada na inne pytanie: jak często wartości wpadają do kolejnych przedziałów? Zamiast dwóch list współrzędnych potrzebuję jednej listy pomiarów. Na przykład czasu obsługi sześciu syntetycznych zgłoszeń:
import matplotlib.pyplot as plt

minutes = [1, 2, 2, 4, 5, 7]
edges = [0, 3, 6, 9]

fig, ax = plt.subplots(figsize=(8, 4), layout="constrained")
ax.hist(minutes, bins=edges, edgecolor="black")
ax.set(
    title="Czas obsługi zgłoszeń: dane syntetyczne",
    xlabel="Czas obsługi [min]",
    ylabel="Liczba zgłoszeń",
)
ax.set_xticks(edges)
plt.show()
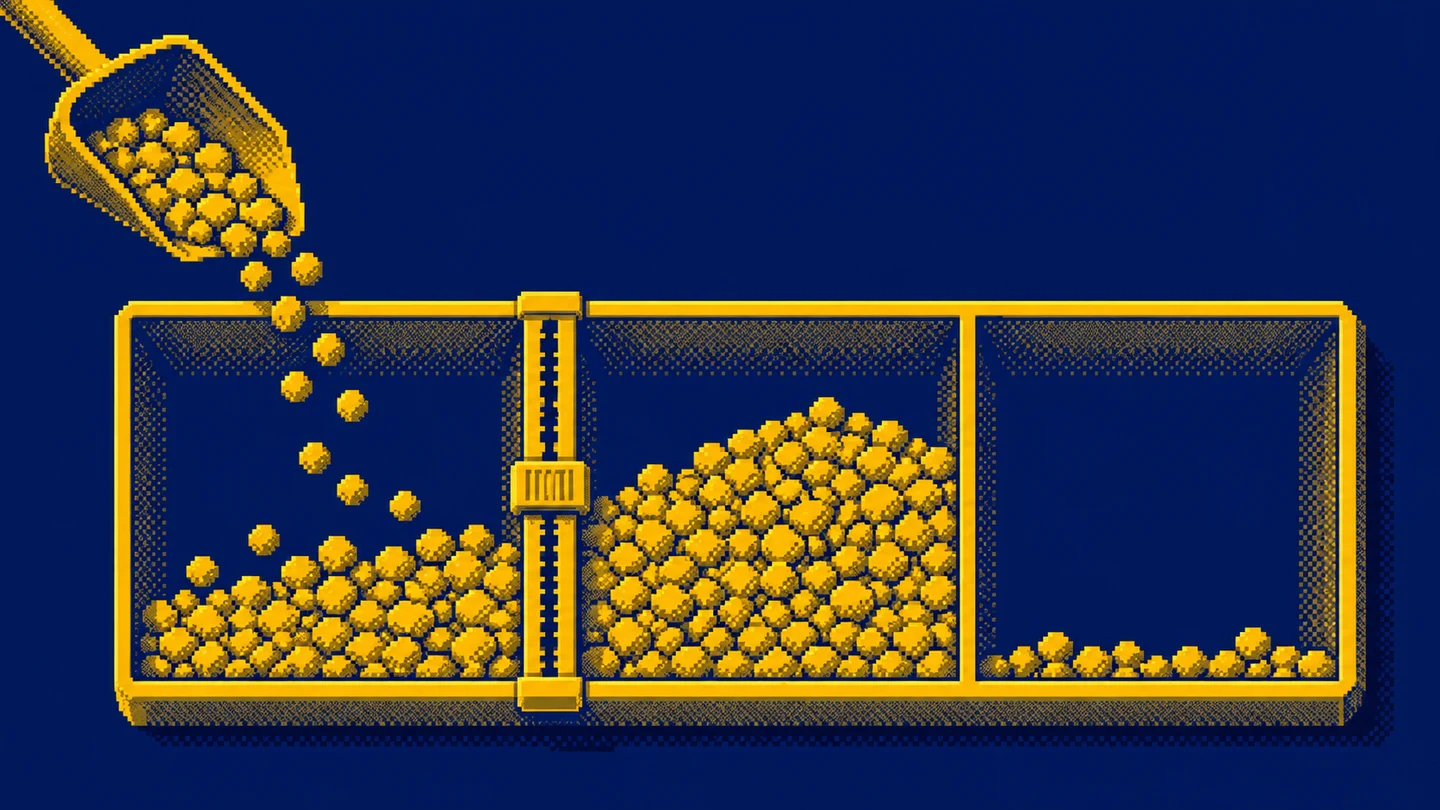
Liczności można prześledzić ręcznie. W przedziale od 0 włącznie do 3 wyłącznie są wartości 1, 2 i 2, więc pierwsza kolumna ma wysokość 3. W drugim przedziale, od 3 do 6 wyłącznie, są 4 i 5: wysokość 2. W ostatnim, od 6 do 9 włącznie, jest 7: wysokość 1. Razem sześć zgłoszeń.
To reguła z dokumentacji hist: przedziały poza ostatnim są lewostronnie domknięte i prawostronnie otwarte. Ostatni uwzględnia obie granice. Gdyby w danych pojawiło się dokładnie 3, trafiłoby do drugiego przedziału; 9 znalazłoby się w ostatnim.
Liczba przedziałów zmienia opowieść
Domyślna liczba przedziałów w hist wynosi 10. Taki domyślny wybór nie jest uzasadnieniem analitycznym. Przy sześciu obserwacjach dziesięć przedziałów może rozbić obraz na prawie puste fragmenty. Przy znacznie większej próbie zbyt mało przedziałów może ukryć istotne różnice.
Ja najpierw wybieram granice, które da się zrozumieć w kontekście pomiaru, a potem sprawdzam, czy niewielka zmiana podziału zmienia ogólny wniosek. Jeśli cała historia znika po przesunięciu jednej granicy, potrzebuje ostrożniejszego opisu. Przy porównaniu dwóch grup stosuję te same granice, żeby różnica wyglądu nie wynikała wyłącznie z ustawień.
W przykładzie wszystkie wartości mieszczą się w podanych granicach. Własne granice mogą jednak pozostawić część danych poza histogramem. Zanim uznam wysokości słupków za pełną populację, sprawdzam zakres i liczbę uwzględnionych obserwacji. Szczególnie łatwo zapomnieć o tym po zastosowaniu filtra.
Parametr density=True zmienia interpretację osi Y na gęstość. Wtedy pole histogramu jest normalizowane, a suma samych wysokości słupków nie musi wynosić jeden. Dla pierwszego raportu z małą próbą zostaję przy licznościach, bo są prostsze do wyjaśnienia. Przy nierównych szerokościach przedziałów dokładnie opisuję, czy porównuję liczności, czy gęstości.
Tytuł, osie i jednostki wykonują część pracy
Tytuł „Analiza” niczego mi nie wyjaśnia. Wolę „Czas obsługi zgłoszeń”, a przy rzeczywistym raporcie dodaję okres i zakres: jakie zgłoszenia oraz z którego systemu. Jednostka na osi pozwala odróżnić sekundy od minut, wartości brutto od netto i liczbę zamówień od liczby produktów.
W danych syntetycznych oznaczam ich pochodzenie wprost. W raporcie firmowym opisuję źródło i moment aktualizacji obok wykresu albo w podpisie. Odbiorca powinien móc rozpoznać, czy ogląda pełny miesiąc, jego fragment czy porównywalne dni robocze.
ax.set_xticks(period) ustawia pozycje podziałki na wybranych okresach. Nie zmienia współrzędnych obserwacji i nie filtruje danych. Dzięki temu unikasz mylącego opisu ułamkowych numerów okresów, ale nadal musisz dopilnować, co oznaczają liczby w liście period.
Gdy dodaję drugą serię, potrzebuję czytelnych nazw i legendy. Kolor pomaga rozróżniać serie, lecz nie powinien być jedyną informacją. Inny znacznik lub bezpośredni opis przy linii bywa wygodniejszy, zwłaszcza gdy ktoś wydrukuje wykres w skali szarości.
Skala liniowa i logarytmiczna
Skalę logarytmiczną wybieram wtedy, gdy pytanie dotyczy proporcjonalnych zmian na szerokim zakresie dodatnich wartości. Równe odległości na takiej osi oznaczają równe ilorazy, na przykład kolejne dziesięciokrotne wzrosty. Na osi liniowej równe odległości oznaczają równe różnice.
Technicznie, dla utworzonego już ax, wybór wygląda tak:
ax.set_yscale("log")Ta linia jest modyfikacją wykresu, a nie samodzielnym programem. Dodaję ją przed zapisem lub wyświetleniem. W naszym szeregu zamówień zakres 10 do 18 jest niewielki, więc skala liniowa jest wystarczająca. Logarytm tylko skomplikowałby odbiór prostego porównania.
Standardowa skala LogScale dotyczy wartości dodatnich. Zera i wartości ujemne wymagają świadomego postępowania; biblioteka może je maskować albo przycinać zależnie od ustawień. Nie dodaję wszystkim wartościom jedynki bez wyjaśnienia, bo zmieniłbym sens danych. Jeśli wartości ujemne są ważne, wracam do pytania o właściwą skalę i sposób prezentacji.
Wyświetlenie i eksport wykresu
plt.show() prosi o pokazanie otwartych figur. Zachowanie zależy od środowiska i backendu: w notebooku wynik może pojawić się pod komórką, w skrypcie w osobnym oknie, a na serwerze bez interfejsu graficznego wygodniejszy będzie zapis do pliku.
Dla figury fig utworzonej w pierwszym przykładzie dodaję przed show():
fig.savefig("orders.png", dpi=150, bbox_inches="tight")Figure.savefig zapisuje tę konkretną figurę. Rozszerzenie wskazuje tu PNG. Nazwa jest względna wobec katalogu pracy, a istniejący plik o tej samej nazwie może zostać zastąpiony. Do ćwiczenia wybierz osobny katalog i świadomie nazwij wynik.
Przy rozmiarze 8 na 4 cale i 150 DPI podstawowe płótno ma 1200 na 600 pikseli. Opcja bbox_inches="tight" dopasowuje obszar eksportu do zawartości, więc końcowe wymiary mogą się różnić. Jeśli odbiorca wymaga dokładnych wymiarów, ustal je osobno i sprawdź gotowy plik.
Dokumentacja show opisuje także kolejność zapisu: blokujące wyświetlenie może zamknąć figurę z perspektywy pyplot. Zachowanie referencji fig daje większą kontrolę. W prostym skrypcie stosuję konsekwentnie kolejność: przygotuj, opisz, zapisz, wyświetl.
Co sprawdzam przed przekazaniem wykresu
Najpierw wracam do danych. Czy każda obserwacja jest policzona raz? Czy obie listy opisują te same rekordy w tej samej kolejności? Jeśli lista mas pochodzi z jednego sortowania, a czasy z drugiego, wykres punktowy może wyglądać wiarygodnie i jednocześnie przedstawiać zmyślone pary.
Potem sprawdzam zakres: braki, filtry, niepełny okres i wartości poza ustawionymi granicami. Pusty wykres może oznaczać problem z filtrem albo typem danych. Tytuł i kolory nie naprawią błędu przygotowania źródła. Do tego etapu przyda się wprowadzenie do analizy w pandas.
Na końcu oglądam plik w rozmiarze, w którym zobaczy go odbiorca. Czytelny wykres na szerokim ekranie może mieć mikroskopijne etykiety po wklejeniu do dokumentu. Skracam tytuł, ograniczam dekoracje i sprawdzam, czy jednostka nadal pozostaje widoczna. Jeśli wniosek wymaga kilku zdań objaśnienia, dopisuję je obok zamiast upychać całą analizę w legendzie.
Brak pomiaru i zero opowiadają inne historie
Załóżmy, że w drugim okresie system nie dostarczył danych. Wpisanie zera w miejsce braku zasugeruje odbiorcy, że nie było zamówień. To znacznie mocniejszy komunikat niż „nie znam wyniku”. W takim przypadku najpierw ustalam, czy pomiar rzeczywiście nie istnieje, czy tylko czeka na aktualizację. Opis luki powinien być widoczny również dla osoby, która zobaczy sam plik z wykresem.
Podobny problem pojawia się przy porównywaniu miesięcy. Jeśli jeden miesiąc obejmuje wszystkie dni, a drugi tylko pierwszych kilka, zwykłe połączenie sum może stworzyć pozorny spadek. Ja oznaczam częściowy okres albo porównuję ten sam zakres dni. Nie przedłużam linii prognozą bez wyraźnego odróżnienia jej od danych zaobserwowanych.
Warto też sprawdzić zmiany jednostki. Jeśli wcześniejszy eksport zawierał czas w sekundach, a nowy w minutach, wykres może pokazać gwałtowną poprawę. Biblioteka nie zna znaczenia liczby 60. Dopiero definicja kolumny mówi, czy chodzi o minutę, godzinę, sztuki czy odsetek. Dlatego jednostkę ustalam przy przygotowaniu danych, a etykietę traktuję jako widoczne potwierdzenie tej decyzji.
Gdy porównuję dwie serie na osobnych panelach, patrzę na zakresy osi. Automatyczne dopasowanie każdego panelu może sprawić, że niewielka i duża zmiana zajmą podobną wysokość. Zależnie od pytania wspólna skala może być przydatna, ale wymaga obejrzenia obu serii. Najpierw określam, czy chcę pokazać poziom wartości, czy kształt zmian.
Histogram i słupki kategorii odpowiadają na inne pytania
Trzy kolumny histogramu z naszego przykładu oznaczają przedziały czasu. Ich kolejność wynika z osi liczbowej. Kolumny opisane nazwami „telefon”, „e-mail” i „czat” oznaczałyby kategorie kanału kontaktu. Takie dane przygotowuję jako liczności kategorii i przedstawiam wykresem słupkowym. Nie podaję numerów kategorii do histogramu, licząc na to, że biblioteka odgadnie ich znaczenie.
Wyobraź sobie pięć kontaktów: dwa telefoniczne, dwa mailowe i jeden na czacie. W porównaniu kanałów interesują mnie te trzy liczności. W analizie czasu obsługi te same kontakty mogłyby należeć do zupełnie innych grup czasowych. Zmiana rodzaju wykresu oznacza tu zmianę pytania, a nie tylko zamianę dekoracji.
Przed agregacją sprawdzam też, co liczę. Jeden kontakt może dotyczyć kilku tematów, a jedno zgłoszenie może zawierać kilka kontaktów. Jeśli chcę policzyć zgłoszenia, lista wszystkich wiadomości będzie wymagała ustalenia unikalnego identyfikatora zgłoszenia. Nawet idealnie dobrany histogram nie naprawi takiej różnicy poziomu szczegółowości.
Dla powtarzalnego raportu zapisuję definicję obserwacji i przedziałów razem z kodem tworzącym wykres. Osoba poprawiająca raport za miesiąc powinna rozumieć, dlaczego granica wynosi trzy minuty i co obejmuje ostatni przedział. Właśnie w takich małych decyzjach kod staje się czytelnym opisem analizy, a wykres zachowuje sens po zmianie autora.
Przed wysłaniem proszę jeszcze o jedną rzecz: odczytaj wykres tak, jakbyś nie znał kodu. Zapisz, co oznacza pojedynczy punkt i skąd wzięła się populacja. Jeżeli do odpowiedzi musisz zajrzeć do zmiennych programu, podpis potrzebuje uzupełnienia. W raportach przekazywanych dalej kontekst łatwo ginie, bo ktoś kopiuje sam obraz bez towarzyszącej wiadomości. Krótki podpis z okresem, jednostką i źródłem chroni wtedy sens porównania. Nie musi zawierać całej metodologii, ale powinien wskazywać najważniejsze ograniczenie. Przy naszym histogramie jest nim mała syntetyczna próba, a przy szeregu zamówień sztuczne cztery okresy bez danych o przyczynach zmiany.
Ćwiczenie: trzy pytania do tych samych umiejętności
Narysuj syntetyczną liczbę zamówień w czterech okresach. Opisz jednym zdaniem, co oznacza odcinek między obserwacjami. Następnie przygotuj wykres punktowy masy i czasu pakowania. Zapisz jedno możliwe wyjaśnienie związku oraz jedną rzecz, której sam wykres nie rozstrzyga.
Na końcu odtwórz histogram sześciu czasów obsługi. Przed uruchomieniem policz ręcznie obserwacje w trzech przedziałach, a potem przesuń granicę z 3 na 2. Zwróć uwagę na wartości równe granicy. To małe ćwiczenie pokazuje, ile znaczenia kryje się w jednym parametrze bins.
Zapisz każdy wykres z jednostkami, informacją o danych syntetycznych i jednozdaniowym opisem. Ja uznałbym to za dobry pierwszy rezultat: potrafisz wybrać wykres, wyjaśnić jego dane i przekazać komuś plik, którego nie trzeba zgadywać.
Film po polsku
Poniżej pozostaje film KajoData o histogramie i statystyce, zachowany z pierwotnego wpisu. Przykłady kodu powyżej są niezależne od filmu.
Najważniejsze w pigułce
Czy przy kilku obserwacjach wykres liniowy jest błędem?
Sama liczba punktów tego nie rozstrzyga. Linia może pokazać uporządkowany szereg, jeśli odbiorca rozumie, co oznacza połączenie między pomiarami.
Do którego przedziału histogramu trafia wartość graniczna?
Poza ostatnim przedziałem Matplotlib uwzględnia lewą granicę i wyklucza prawą. Ostatni przedział uwzględnia obie granice.
Jak zapisać wykres do pliku?
Wywołaj fig.savefig z nazwą i parametrami eksportu. W prostym skrypcie wykonaj zapis przed plt.show i sprawdź gotowy plik.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
