
KajoData / SQL
Podstawy SQL: od pierwszej tabeli do wyniku, któremu można zaufać
Zapytanie może działać i nadal odpowiadać na niewłaściwe pytanie. Przechodzę przez podstawy SQL na sześciu zamówieniach: od wyboru kolumn do grupowania, braków i kontroli wyniku.
Kiedy uczę się nowego narzędzia, chcę szybko sprawdzić, do czego mi się przyda. W SQL takim momentem jest pierwsze pytanie do tabeli: ile zamówień zrealizowano i jaka była ich wartość? Kilka linijek kodu daje odpowiedź. Potem odkrywam, że anulowane zamówienia też weszły do sumy. I właśnie wtedy zaczyna się właściwa nauka.
SQL służy między innymi do odczytywania i przekształcania danych w relacyjnych bazach. Opisuję wynik, którego oczekuję, a silnik organizuje wykonanie zapytania. Na początku skupiam się na tym, jakie wiersze wybieram, co liczę i dlaczego. Lista wszystkich poleceń może poczekać. Najpierw potrzebuję sensownego pytania oraz możliwości sprawdzenia odpowiedzi.
W tym przewodniku używam SQLite i syntetycznej tabeli sześciu zamówień. Przykłady wykonuj kolejno w jednej pustej bazie ćwiczeniowej. Nie potrzebujesz danych firmy ani osobnego serwera. Pokażę też modyfikację w transakcji zakończonej cofnięciem, żeby cały eksperyment pozostawił dane wejściowe bez zmian.
Baza, tabela i wynik zapytania
Baza przechowuje dane, tabela organizuje je w kolumny i wiersze, a zapytanie opisuje operację. Wynik SELECT przypomina kolejną tabelę, ale samo jego wyświetlenie nie oznacza zapisania nowego trwałego obiektu. Mogę wielokrotnie pytać te same dane o różne rzeczy, bez ręcznego kopiowania arkuszy na każdy wariant analizy.
W naszej tabeli jeden wiersz oznacza jedno zamówienie. Kolumna order_id identyfikuje je jednoznacznie, channel opisuje kanał, status etap procesu, a amount_cents kwotę w groszach. Wszystkie kwoty dotyczą jednej waluty. Znajomość tych założeń jest równie potrzebna jak znajomość słowa SELECT.
Gdyby wiersz oznaczał pozycję zamówienia, liczenie wierszy dawałoby liczbę pozycji. Gdyby tabela zawierała historię statusów, jedno zamówienie mogłoby wystąpić wielokrotnie. Zanim zaczniesz pisać zapytania na własnych danych, zapisz jednym zdaniem, co reprezentuje wiersz. Ten prosty nawyk oszczędza sporo późniejszego zdziwienia.
Jak uruchomić przykłady
Możesz użyć programu obsługującego SQLite albo jego konsoli. W konsoli otwarcie nowej lokalnej bazy tworzy plik, a otwarcie bazy w pamięci pozwala ćwiczyć bez trwałego pliku. Dokumentacja konsoli SQLite opisuje te warianty. Wklej najpierw blok tworzący tabelę, potem kolejne zapytania.
W SQLite nie zaczynam od CREATE DATABASE. To ważna różnica względem części serwerowych baz, gdzie takie polecenie występuje. SQL ma wspólny fundament, lecz konkretne produkty różnią się obsługą baz, dat, typów i dodatkowych funkcji. Tutaj wszystkie wykonywalne przykłady odnoszą się do SQLite. Nie obiecuję bezpośredniego uruchomienia każdego fragmentu na dowolnym silniku.
Jeżeli zobaczysz komunikat, że tabela już istnieje, prawdopodobnie drugi raz uruchamiasz blok przygotowania w tej samej bazie. Otwórz nową bazę ćwiczeniową. Nie dodawaj odruchowo polecenia usuwającego tabelę, szczególnie gdy nie masz pewności, do jakiego środowiska jesteś połączony. Nazwa połączenia też jest częścią pracy z SQL.
Tworzę mały zbiór danych
-- example: fixture
CREATE TABLE orders (
    order_id INTEGER PRIMARY KEY,
    channel TEXT NOT NULL,
    status TEXT NOT NULL,
    amount_cents INTEGER
);
INSERT INTO orders (order_id, channel, status, amount_cents)
VALUES
    (1, 'web', 'completed', 10000),
    (2, 'web', 'cancelled', 5000),
    (3, 'store', 'completed', 20000),
    (4, 'web', 'completed', NULL),
    (5, 'store', 'completed', 0),
    (6, 'web', 'completed', 10000);
CREATE TABLE określa strukturę, a INSERT INTO dodaje przykładowe wiersze. Wskazuję kolumny INSERT jawnie, żeby kolejność wartości była widoczna. Tekst zapisuję w pojedynczych apostrofach. NULL występuje bez apostrofów, ponieważ oznacza brak wartości, a nie napis złożony z czterech liter.
Klucz główny chroni tutaj przed powtórzeniem numeru zamówienia. NOT NULL wymaga wartości dla kanału i statusu. Celowo dopuszczam nieznaną kwotę, aby pokazać jej wpływ na obliczenia. Reguły deklaracji tabel opisuje CREATE TABLE w SQLite. Projektowanie kompletnego modelu bazy wymaga więcej decyzji, ale do naszego pytania wystarczy ten zakres.
SQLite ma charakterystyczny system typów, opisany w dokumentacji typowania. Sama nazwa typu w zwykłej tabeli nie daje takich samych gwarancji jak we wszystkich innych bazach. W przykładzie kontroluję wartości wejściowe; w realnym procesie sprawdzam również, czy kwota faktycznie jest liczbą oraz czy jednostka jest poprawna.
SELECT wybiera kolumny
-- example: selected
SELECT order_id, channel, amount_cents
FROM orders
ORDER BY order_id;
Wynik ma sześć wierszy i trzy wybrane kolumny. SELECT mówi, co chcę zobaczyć, FROM wskazuje źródło, a ORDER BY porządkuje rezultat. Średnik kończy polecenie. Rozbijam zapytanie na linie, bo łatwiej wtedy zauważyć brak przecinka, omyłkową kolumnę albo warunek dopisany w niewłaściwym miejscu.
Na etapie rozpoznawania danych przydaje się także SELECT *, czyli wybór wszystkich kolumn. W gotowym raporcie wolę listę jawną. Wiem wtedy, jakie pola są częścią wyniku, i nie przenoszę przypadkowo dodatkowych kolumn po zmianie struktury źródła. Nazwa kolumny powinna pomagać odbiorcy, a nie wymagać zaglądania do mojego notesu.
Bez ORDER BY nie opieram się na zaobserwowanej kolejności wierszy. To, że dzisiaj tabela wygląda na posortowaną według ID, nie stanowi umowy o kolejności wyniku. Takie drobne założenie często wychodzi dopiero wtedy, gdy ktoś porównuje dwa eksporty i znajduje pozorne różnice.
WHERE wybiera wiersze przed liczeniem
-- example: filtered
SELECT order_id, amount_cents
FROM orders
WHERE status = 'completed'
  AND channel = 'web'
ORDER BY order_id;
Otrzymuję zamówienia 1, 4 i 6. Anulowane zamówienie 2 odpada, mimo że pochodzi z kanału web. Warunki połączone AND muszą być jednocześnie spełnione. Właśnie tutaj zamieniam pytanie „zrealizowane zamówienia internetowe” na konkretną regułę wyboru rekordów.
Zanim dodam agregację, sprawdzam wybrane identyfikatory. Na małym zbiorze mogę je przejrzeć ręcznie. Na większym sprawdzam próbkę oraz liczebności dla istotnych grup. Jeśli filtr wybiera niewłaściwe dane, poprawnie działająca SUM tylko starannie zsumuje niewłaściwy zbiór. Matematyka nie zgadnie, co miałem na myśli.
Przy łączeniu AND oraz OR stosuję nawiasy, które pokazują intencję. Reguła „zrealizowane i pochodzące z web albo store” wymaga jasnego określenia, czy status dotyczy obu kanałów. Kolejność operatorów SQLite określa sposób odczytu zapisu, ale czytelny nawias zwykle jest tańszy niż późniejszy spór o wynik.
NULL wymaga osobnego pytania
-- example: missing
SELECT order_id
FROM orders
WHERE amount_cents IS NULL
ORDER BY order_id;
Wynikiem jest zamówienie 4. Brak sprawdzam przez IS NULL, a znaną wartość przez IS NOT NULL. Porównanie amount_cents = NULL nie zastępuje tej kontroli. Zwykłe porównanie z nieznaną wartością nie daje prawdy potrzebnej do przejścia przez WHERE. Ta zasada jest jedną z najczęstszych przyczyn pustego wyniku początkującego zapytania.
Zero zamówienia 5 pozostaje pełnoprawną liczbą. Nie wrzucam go do jednego worka z brakiem kwoty. W naszym przykładzie mogę policzyć wszystkie pięć zrealizowanych zamówień, ale ich pełna łączna wartość pozostaje nieznana. Wiem jedynie, ile wynoszą kwoty dostępne. Tę różnicę zachowuję również w nazwie i opisie miary.
COUNT, SUM i AVG odpowiadają na różne pytania
-- example: totals
SELECT
    COUNT(*) AS orders_count,
    COUNT(amount_cents) AS known_amounts,
    SUM(amount_cents) AS known_total_cents,
    AVG(amount_cents) AS known_average_cents
FROM orders
WHERE status = 'completed';
Wynik to kolejno 5, 4, 40000 oraz 10000. Mam pięć zamówień, cztery znane kwoty, sumę znanych kwot 400 zł i ich średnią 100 zł. COUNT z nazwą kolumny pomija NULL. SUM i AVG również pracują tutaj na dostępnych wartościach. Zachowanie tych funkcji opisuje dokumentacja agregacji SQLite.
Patrzę szczególnie na mianownik średniej. Wartości 100, 200, 0 i 100 dają sumę 400 oraz cztery obserwacje. Podzielenie przez pięć oznaczałoby inne założenie. Nie dopisuję go tylko po to, żeby wszystkie kolumny raportu wyglądały na kompletne. Przy prezentacji mogę pokazać obok liczbę brakujących kwot, czyli w tym przypadku jeden.
GROUP BY zmienia ziarnistość wyniku
-- example: grouped
SELECT channel,
       COUNT(*) AS orders_count,
       COUNT(amount_cents) AS known_amounts,
       SUM(amount_cents) AS known_total_cents
FROM orders
WHERE status = 'completed'
GROUP BY channel
ORDER BY channel;
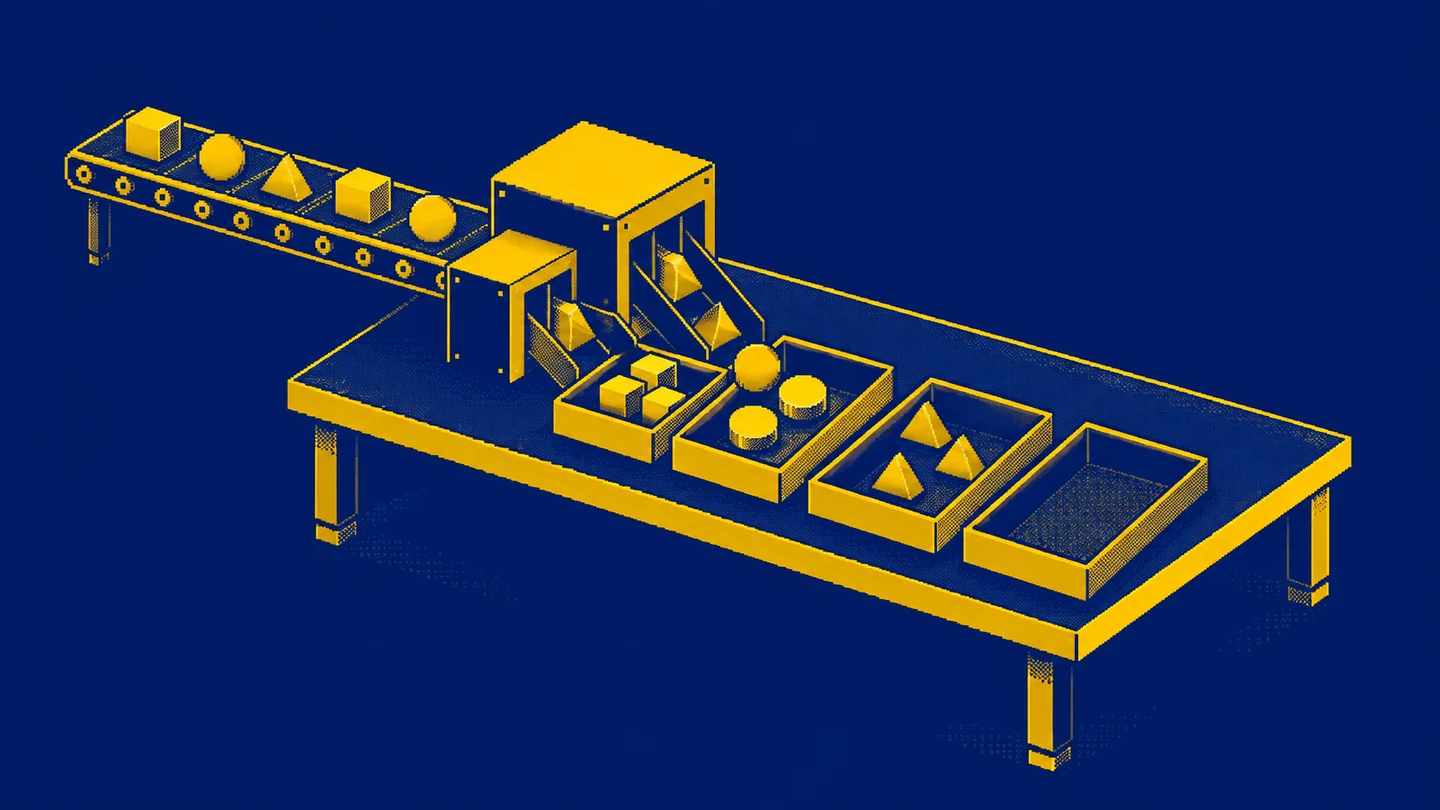
Dostaję dwa wiersze. Dla store wartości wynoszą 2, 2 i 20000. Dla web: 3, 2 i 20000. Jeden wiersz wyniku reprezentuje teraz kanał, choć jeden wiersz źródła reprezentował zamówienie. Ta zmiana poziomu szczegółowości jest sednem grupowania i powodem, dla którego nie dodaję przypadkowo numeru zamówienia do wyniku.
W zapytaniu grupującym wybieram kolumny grupowania albo wyrażenia agregujące. SQLite dopuszcza też pewne zapisy z dodatkowymi nieagregowanymi kolumnami, ale jako początkujący nie opieram na tym raportów. Chcę jednoznacznie wiedzieć, co reprezentuje każda komórka. Opis SELECT przedstawia także te szczególne zachowania silnika.
HAVING wybiera gotowe grupy
-- example: having
SELECT channel, COUNT(*) AS orders_count
FROM orders
WHERE status = 'completed'
GROUP BY channel
HAVING COUNT(*) >= 3
ORDER BY channel;
Zostaje web z trzema zamówieniami. Najpierw ograniczam wejściowe wiersze do zrealizowanych zamówień, następnie grupuję po kanale, a potem zostawiam wystarczająco liczne grupy. To użyteczny sposób myślenia o wyniku. Nie jest jednak obietnicą dokładnej fizycznej kolejności operacji wewnątrz silnika.
W praktyce rozdzielam dwa zdania: „Jakie rekordy mogą wejść do analizy?” oraz „Jakie grupy chcę pokazać?”. Pierwsze prowadzi do WHERE, drugie często do HAVING. Gdy mieszam te pytania, zaczynam kombinować ze składnią zamiast sprawdzić definicję raportu. Zapisanie wymagań zwykłym językiem pomaga szybciej niż losowe przesuwanie warunku.
Sortowanie, remisy i ograniczenie wyniku
-- example: largest
SELECT order_id, amount_cents
FROM orders
WHERE status = 'completed'
  AND amount_cents IS NOT NULL
ORDER BY amount_cents DESC, order_id
LIMIT 2;
Otrzymuję 3 z kwotą 20000 oraz 1 z kwotą 10000. Zamówienia 1 i 6 mają remis, dlatego dodaję ID jako drugi klucz sortowania. LIMIT zwraca tutaj dwa wiersze, a nie wszystkie zamówienia zajmujące dwa różne poziomy wartości. Jeżeli biznes chce zachować remisy, potrzebna jest inna definicja oraz odpowiednie zapytanie.
Ograniczenie wyniku pomaga oglądać próbkę, lecz nie zastępuje reprezentatywnego doboru danych. Pierwsze dwa największe zakupy celowo pokazują ekstremum. Nie wnioskuję na ich podstawie o przeciętnym kliencie. Podobnie szybki podgląd kilku rekordów z nowej tabeli służy rozpoznaniu struktury, a nie potwierdzeniu jakości całego zbioru.
Modyfikacje ćwiczę w kontrolowanej transakcji
-- example: rollback
BEGIN TRANSACTION;
UPDATE orders
SET amount_cents = 12000
WHERE order_id = 1;
SELECT order_id, amount_cents FROM orders WHERE order_id = 1;
ROLLBACK;
Wewnątrz transakcji widzę kwotę 12000. Po ROLLBACK ponowne odczytanie zamówienia 1 daje pierwotne 10000. To ćwiczenie wykonuję wyłącznie w lokalnej tabeli przygotowanej wyżej. Transakcje SQLite pozwalają zatwierdzić zmiany przez COMMIT albo cofnąć aktywną transakcję przez ROLLBACK.
Przed UPDATE sprawdzam odpowiadający mu SELECT z tym samym warunkiem. Brak WHERE może objąć wszystkie wiersze, zgodnie z opisem UPDATE. DELETE usuwa wiersze, a DROP TABLE usuwa tabelę. Nie potrzebuję ich uruchamiać na prawdziwych danych, żeby zrozumieć różnicę. Po zatwierdzeniu zmiany zwykłe późniejsze ROLLBACK nie jest magicznym przyciskiem cofającym historię.
Jak sprawdzam, że wynik ma sens
Sumuję liczebności kanałów: dwa plus trzy daje pięć zrealizowanych zamówień. Sumy znanych kwot kanałów dają 40000, tak samo jak podsumowanie całości. Sprawdzam także zamówienie anulowane: jego 5000 nie może znaleźć się w tych wynikach. Kilka niezależnych kontroli lepiej opisuje poprawność niż samo „zapytanie się wykonało”.
Następnie zmieniam dane ćwiczeniowe. Dodanie kolejnego zrealizowanego zamówienia z NULL powinno zwiększyć COUNT(*), pozostawiając COUNT kwoty i jej sumę bez zmian. Gdy nie ma żadnego pasującego wiersza, globalny COUNT daje zero, a SUM i AVG zwracają NULL. Zapytanie z GROUP BY może wtedy nie zwrócić żadnej grupy. Rozróżniam te przypadki w raporcie.
Własne ćwiczenie zacznij od policzenia zrealizowanych zamówień o znanej kwocie co najmniej 10000. Oczekiwane identyfikatory to 1, 3 i 6, liczba trzy, suma 40000. Potem policz wynik osobno dla kanałów i wyjaśnij, dlaczego zero oraz NULL nie przechodzą przez ten sam warunek z różnych powodów.
Błąd składni, pusty wynik i błędna odpowiedź
Te trzy sytuacje rozpatruję osobno. Przy błędzie składni silnik zwykle wskazuje fragment, którego nie potrafił odczytać. Wracam wtedy do najmniejszego działającego zapytania: jednej kolumny i jednej tabeli. Dodaję kolejne elementy pojedynczo. Dzięki temu wiem, czy problem pojawił się po filtrze, agregacji, czy zwykłym przecinku. Wklejenie naraz pięciu poprawek utrudnia zrozumienie przyczyny.
Pusty wynik może być poprawną odpowiedzią. Jeżeli pytam o status, którego nie ma w tabeli, dostanę zero rekordów. Najpierw oglądam faktyczne wartości w źródle, potem porównuję je z warunkiem. Sprawdzam literówki, białe znaki i znaczenie etykiet. Nie poszerzam filtra tylko dlatego, że spodziewałem się jakichś danych. Oczekiwanie jest wskazówką do kontroli, a nie dowodem, że dane powinny istnieć.
Najtrudniejsza jest odpowiedź wyglądająca rozsądnie. Suma obejmująca zamówienie anulowane wyniosłaby tutaj 45000 zamiast 40000. Obie liczby są dodatnie i pasują do typu kolumny. Silnik nie rozpozna, która odpowiada definicji zrealizowanej sprzedaży. Dlatego wracam do identyfikatorów oraz ręcznego rachunku. Na sześciu wierszach potrafię uzasadnić każdą składową, więc używam tego zbioru jak małego sprawdzianu dla zapytania.
Przy zgłaszaniu problemu zapisuję zapytanie, komunikat, nazwę silnika oraz minimalne dane odtwarzające sytuację. Usuwam informacje prywatne i zastępuję je przykładami. Osoba pomagająca ma wtedy szansę uruchomić ten sam przypadek. Sam zrzut ekranu końcowego błędu zwykle pomija część kontekstu, od którego zależy odpowiedź.
Dwa poprawne raporty mogą mierzyć coś innego
Wyobraź sobie, że druga osoba pokazuje sześć zamówień i sumę 45000. Zanim uznam jej SQL za błędny, pytam o zakres. Może świadomie liczy także anulowane rekordy. W takim przypadku różnica wynika z definicji. Zapisuję więc obok wyniku statusy uwzględnione w analizie, jednostkę kwoty oraz sposób traktowania braków. Taki opis pozwala porównywać raporty bez zgadywania.
Kolejnym warunkiem porównania jest moment odczytu. W naszej lokalnej tabeli dane pozostają stałe poza kontrolowanym ćwiczeniem. W działającym systemie nowe zamówienia mogą napływać, a statusy się zmieniać. Dwa zapytania wykonane o różnych godzinach nie muszą dać identycznego wyniku, nawet jeśli mają tę samą logikę. Przy sprawdzaniu zgodności szukam wspólnego zakresu czasowego i tego samego stanu danych.
Nie nazywam sumy kwot automatycznie przychodem firmy. To pojęcie może wymagać rozliczenia zwrotów, podatków, dat księgowania i innych reguł. Nasze ćwiczenie pokazuje sumę znanych kwot zrealizowanych zamówień. Precyzyjna, trochę dłuższa nazwa chroni przed dopisaniem znaczenia, którego w tabeli nie ma. Ładny skrót w nagłówku nie zastąpi definicji miary.
Jeżeli przekazuję wynik dalej, dołączam również liczbę rekordów z brakującą kwotą. Odbiorca widzi wtedy, że 40000 jest sumą dostępnych wartości dla pięciu zamówień, z których jedno nie ma kwoty. Może zdecydować, czy ta niekompletność przeszkadza w jego decyzji. Ukrycie braku za zerem odebrałoby mu tę informację, chociaż sam wykres prawdopodobnie wyglądałby bardziej elegancko.
Co ćwiczyć po pierwszym poprawnym zapytaniu
Kiedy umiesz wyjaśnić te wyniki, przejdź do łączenia tabel, a później do zaawansowanych zapytań SQL. Przy każdym nowym elemencie nadal sprawdzaj ziarnistość, braki i liczebności. Bardziej rozbudowana składnia zwiększa możliwości, ale nie zastępuje kontroli założeń.
Na koniec zapisz własnymi słowami definicję wyniku, kod i oczekiwane liczby dla małej próbki. Taki materiał da się jutro ponownie uruchomić oraz komuś wyjaśnić. To dla mnie lepszy dowód opanowania podstaw niż pamięciowe wyrecytowanie kilkunastu poleceń. Z SQL chcę dostarczać odpowiedzi, które wytrzymują dodatkowe pytanie.
Najważniejsze w pigułce
Czy do nauki SQL muszę postawić serwer bazy danych?
Nie. Przykłady możesz wykonać w SQLite, które działa lokalnie bez osobnego serwera. Później poznaj silnik używany w pracy i jego różnice składni.
Czym różni się WHERE od HAVING?
WHERE wybiera wiersze przed grupowaniem, a HAVING filtruje powstałe grupy. Status zamówienia sprawdzam w WHERE, a warunek na liczbę zamówień grupy w HAVING.
Dlaczego COUNT(*) i COUNT(amount_cents) dają inne wyniki?
COUNT(*) liczy wiersze, a COUNT(amount_cents) pomija NULL w tej kolumnie. Przy nieznanych kwotach liczba zamówień jest więc większa niż liczba znanych kwot.
