
KajoData / Python
Tekst do listy w Pythonie: linie, słowa i puste pola
Wybierz podział na linie lub słowa, zachowaj potrzebne spacje i rozpoznaj moment, w którym prosty split trzeba zastąpić czytnikiem CSV.
Chcesz zamienić plik tekstowy na listę w Pythonie. Zanim dopiszę .split(), ustalam jedną rzecz: co ma być elementem tej listy? Cały wiersz, pojedyncze słowo czy pole oddzielone średnikiem? Od tej odpowiedzi zależy, które informacje zachowam, a które zgubię już przy odczycie.
Pokażę kilka małych przykładów dla Pythona 3.14. Wszystkie dane są syntetyczne. Przykłady opieram na regułach opisanych w dokumentacji; przy własnym pliku trzeba jeszcze sprawdzić jego kodowanie i rzeczywistą strukturę.
Jeden wiersz pliku jako jeden element listy
Załóżmy, że plik notes.txt, zapisany w UTF-8, zawiera trzy linie:
Converting
text to list
in Python
Chcę otrzymać trzy elementy, w tym jeden zawierający całe text to list. Dla małego pliku wybieram:
from pathlib import Path

text = Path("notes.txt").read_text(encoding="utf-8")
lines = text.splitlines()
Oczekiwana zawartość lines:
['Converting', 'text to list', 'in Python']Path.read_text() odczytuje plik i zamyka go po zakończeniu. splitlines() dzieli tekst na linie, domyślnie bez znaków ich końca. Wyrazy wewnątrz linii pozostają razem. Właśnie o taki kształt danych tu chodzi.
Ścieżka względna jest liczona względem bieżącego katalogu pracy programu. Jeśli Python zgłasza FileNotFoundError, sprawdzam najpierw lokalizację pliku. Samo dopisanie kolejnego wywołania split() nie pomoże znaleźć katalogu.
split, splitlines i list: trzy różne operacje
Te wyrażenia wyglądają podobnie, ale odpowiadają na różne pytania:
| Wyrażenie | Element wyniku | Zastosowanie |
|---|---|---|
text.splitlines() |
Linia | Lista opisów lub rekordów zapisanych po jednym w wierszu |
text.split() |
Fragment między białymi znakami | Prosty podział na słowa |
text.split(";") |
Fragment między średnikami | Prosty tekst z ustalonym separatorem |
list(text) |
Pojedynczy znak Unicode | Praca ze znakami, bez rozpoznawania słów |
Dla syntetycznego tekstu "red blue\ngreen" podział split() daje trzy elementy: red, blue, green. Podział splitlines() daje dwa: red blue i green. list() rozbije także spację i znak końca linii na osobne elementy.
Szczegóły podziału opisuje dokumentacja typu str. Z punktu widzenia analizy najważniejszy jest kontrakt danych. Jeśli jeden element ma oznaczać komentarz klienta, rozbijanie go na słowa utrudni późniejsze powiązanie komentarza z rekordem.
Wczytywanie wiersz po wierszu z with open
Gdy chcę jawnie przejść przez linie, korzystam z menedżera kontekstu:
lines = []

with open("notes.txt", "r", encoding="utf-8") as source:
    for line in source:
        lines.append(line.rstrip("\n"))
W zwykłym trybie tekstowym open() normalizuje standardowe końce linii do \n. Usuwam tutaj ten końcowy znak, zachowując pozostałe spacje. Blok with odpowiada za zamknięcie pliku także wtedy, gdy wewnątrz wystąpi wyjątek. To zachowanie opisuje poradnik odczytu plików Pythona.
Ta wersja również buduje całą listę w pamięci. Samo użycie pętli nie oznacza więc, że mogę bez kosztu wczytać dowolnie duży plik. Jeśli potrzebuję tylko policzyć linie albo przetwarzać rekordy kolejno, mogę wykonać pracę wewnątrz pętli i nie odkładać każdej linii do listy.
Zapis przez list comprehension jest krótszy:
with open("notes.txt", encoding="utf-8") as source:
    lines = [line.rstrip("\n") for line in source]
Wybieram go, gdy pojedyncze przekształcenie jest czytelne. Gdy dochodzą reguły odrzucania rekordów, komunikaty o błędach i kilka warunków, zwykła pętla często lepiej pokazuje tok pracy.
strip może usunąć potrzebne dane
strip() bez argumentu usuwa białe znaki z obu końców tekstu. To obejmuje spacje i tabulatory, a nie tylko koniec linii. Dla " red \n" otrzymam "red". Jeśli początkowe wcięcie ma znaczenie, właśnie je straciłem.
Dlatego przed czyszczeniem rozstrzygam, czy spacje są dekoracją, czy częścią wartości. W kodzie produktu, eksporcie o stałej szerokości lub fragmencie kodu mogą być istotne. W ręcznie wpisanej liście miast czasem warto je usunąć, ale jest to decyzja o danych.
Nie używam też strip(".txt") do usuwania rozszerzenia pliku. Argument strip jest zbiorem znaków usuwanych z końców, a nie całym przyrostkiem. Taką regułę łatwo przeoczyć, bo na jednym przykładzie wynik może wyglądać przekonująco.
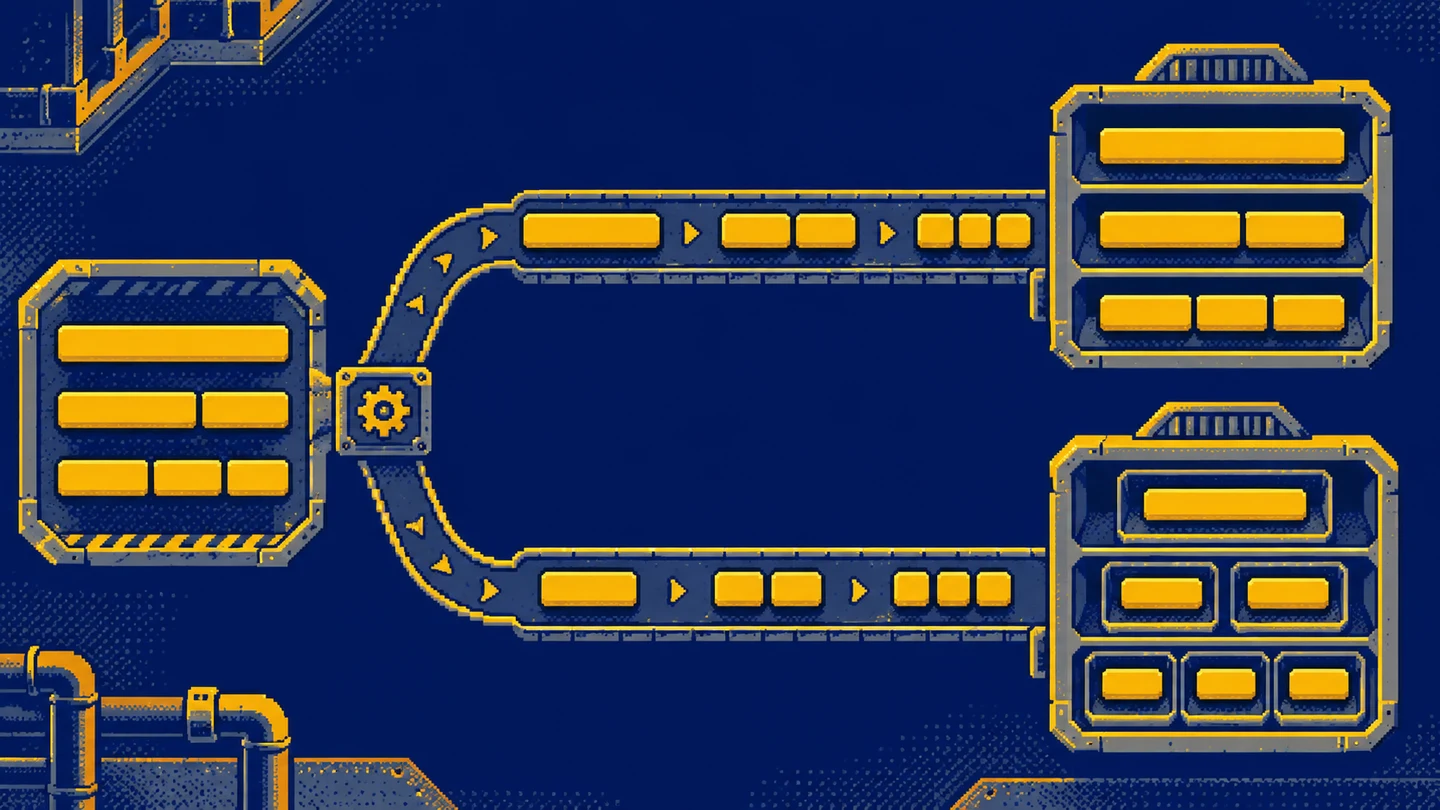
Lista list: słowa z każdej linii osobno
Wróćmy do trzech linii z początku. Teraz chcę zachować granicę między wierszami, ale wewnątrz każdego wiersza potrzebuję słów:
with open("notes.txt", encoding="utf-8") as source:
    rows = [line.split() for line in source]
Oczekiwana zawartość:
[['Converting'], ['text', 'to', 'list'], ['in', 'Python']]Zewnętrzna lista odpowiada liniom. Wewnętrzne listy mają różne długości, bo liczba słów się różni. Nie zakładam więc, że każda z nich ma element o indeksie 2. Drugi wiersz go ma, pierwszy już nie.
Dodatkowe strip() przed split() bez separatora jest w tym przykładzie zbędne. Ten wariant podziału sam pomija białe znaki na brzegach i traktuje kolejne białe znaki jako jeden separator. Pozostawienie jednej operacji ułatwia wyjaśnienie, co właściwie zmienia dane.
Puste linie i puste pola wymagają osobnej decyzji
Syntetyczny tekst "red\n\nblue\n" po splitlines() daje ['red', '', 'blue']. Pusta linia w środku pozostaje elementem. Końcowy znak nowej linii nie tworzy kolejnego pustego elementu. Dla pustego tekstu wynikiem jest pusta lista.
Jeśli plik ma puste linie, wersja [line.split() for line in source] zachowa je jako puste listy. To może być przydatne: pusta linia czasem oddziela sekcje. Nie usuwam jej automatycznie tylko po to, żeby wynik wyglądał schludniej.
Jawny separator działa inaczej. "red;;blue;".split(";") daje ['red', '', 'blue', '']. Puste pola mogą oznaczać brakujące wartości. Po ich skasowaniu kolejne dane przesunęłyby się na niewłaściwe pozycje. W tabeli to już konkretny błąd, nawet jeżeli program nadal działa.
Plik CSV czytaj narzędziem do CSV
Nazwisko, uwaga albo nazwa produktu mogą zawierać separator. Wtedy prosty podział po przecinku przestaje odwzorowywać kolumny. Jeżeli źródłem jest CSV z cytowanymi polami, korzystam z modułu csv:
import csv

with open("products.csv", encoding="utf-8", newline="") as source:
    rows = list(csv.reader(source, delimiter=";"))
Ten przykład zakłada separator ;. Nagłówek, jeśli istnieje w pliku, również stanie się wierszem listy. Czytnik zwraca tu pola jako tekst; zamiana ceny lub daty na odpowiedni typ jest kolejnym etapem.
Wymóg newline="" jest zaleceniem dokumentacji modułu. Nie zgaduję także separatora na podstawie rozszerzenia: plik z końcówką .csv może pochodzić z systemu używającego innych ustawień eksportu.
Kodowanie i rozmiar pliku
Jawne encoding="utf-8" opisuje założenie, a nie naprawia dowolnego pliku. Przy UnicodeDecodeError sprawdzam format eksportu u źródła. Opcja ignorowania błędów może skasować część nazwy produktu albo identyfikatora, więc nie traktuję jej jako neutralnej poprawki.
Po odczycie sprawdzam kilka znanych wartości z polskimi znakami. Brak wyjątku nie gwarantuje, że tekst odczytano zgodnie z intencją autora pliku. Ważny jest także dalszy etap: lista z milionem elementów zajmuje pamięć niezależnie od tego, czy utworzyłem ją jedną linijką, czy pętlą.
Jeśli dopiero zaczynasz pracę z danymi, zobacz też pierwszy raport w pandas. Podział tekstu przygotowuje dane do analizy, ale jeszcze nie rozstrzyga ich poprawności.
Ćwiczenie: ustal, czego nie wolno zgubić
Przygotuj mały plik z dwoma opisami, pustą linią i opisem rozpoczynającym się od dwóch spacji. Na kartce zapisz oczekiwaną listę dla dwóch zastosowań: wiernego zachowania linii i listy niepustych, oczyszczonych opisów.
Następnie wybierz operacje osobno dla każdego przypadku. Sprawdź, czy zmieniła się liczba elementów, wcięcia oraz odstępy wewnątrz opisu. Dopiero później skróć zapis do list comprehension. Ja chcę najpierw wiedzieć, jakie dane wyjdą z przekształcenia. Zwięzły kod jest miłym dodatkiem.
Najważniejsze w pigułce
Jak zamienić każdą linię pliku na element listy?
Dla małego pliku użyj Path.read_text z jawnym kodowaniem i splitlines. Przy odczycie liniami zastosuj with open i świadomie usuń tylko końce linii.
Czy strip usuwa tylko znak nowej linii?
Nie. Bez argumentu usuwa białe znaki z obu końców, w tym spacje i tabulatory. Może więc usunąć znaczące wcięcia.
Czy split wystarczy do wczytania CSV?
Przy cytowanych polach i separatorach wewnątrz wartości potrzebny jest czytnik csv.reader z ustawieniami zgodnymi z eksportem.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
