
KajoData / SQL
Zaawansowane zapytania SQL: CTE, okna i ranking na jednym przykładzie
Zapytanie z trzema CTE może wyglądać imponująco i nadal źle liczyć sprzedaż. Pokazuję, jak buduję analizę krok po kroku, pilnując znaczenia wiersza, braków danych i kolejności obliczeń.
Zaawansowany SQL zaczyna się dla mnie w momencie, gdy potrafię wyjaśnić, co oznacza każdy etap obliczenia. Samo dodanie WITH, kilku złączeń i funkcji okna nie daje takiej gwarancji. Można napisać bardzo eleganckie zapytanie, które z pełnym spokojem podwoi przychód albo schowa klienta bez zakupów.
Dlatego przeprowadzę jedną analizę na wspólnych danych. Chcę podsumować opłacone zamówienia ze stycznia, porównać klientów, zachować remisy i zobaczyć narastającą wartość zamówień. Po drodze pokażę podzapytanie, CTE, agregację, złączenie oraz funkcje okna. Każde narzędzie dostanie konkretne zadanie.
Przykłady są syntetyczne i przeznaczone dla SQLite z obsługą funkcji okna. Uruchamiam je w bazie w pamięci przez node:sqlite z Node 24. Nie mieszam tego kodu ze składnią dynamicznego SQL z SQL Servera. Przy przenoszeniu do innego silnika sprawdzam typy, obsługę dat, dzielenie i reguły planowania.
Najpierw definiuję wynik, który chcę dostać
W tabeli klientów jeden wiersz oznacza jednego klienta. W tabeli zamówień jeden wiersz oznacza jedno zamówienie. Kwotę zapisuję w całkowitych jednostkach umownych, aby przykład był łatwy do policzenia ręcznie. Wszystkie rekordy należą do jednego systemu i używają tej samej jednostki.
W podsumowaniu chcę jeden wiersz na klienta, również na takiego, który niczego nie kupił. Ranking ma natomiast obejmować klientów z opłaconymi zamówieniami i kompletnymi kwotami. To dwa różne wyniki. Brak zakupów i brak danych o kwocie wymagają osobnych interpretacji, choć na ekranie oba przypadki mogą wyglądać jak zero.
Przed pisaniem zapytania zapisuję te warunki zwykłymi zdaniami. Dzięki temu później potrafię rozstrzygnąć, czy filtr powinien znaleźć się przed agregacją, czy po niej. Nie oceniam poprawności po tym, czy zapytanie zwróciło jakąś tabelę. Tabelę zwróci prawie zawsze, nawet gdy zupełnie źle zrozumiem problem.
Mały zbiór ma zawierać niewygodne przypadki
W danych celowo zostawiam dwóch klientów z takim samym wynikiem, klienta z brakującą kwotą i prawidłowym zerem, klienta bez zamówień, anulowany zakup oraz zakup z następnego miesiąca. Dzięki temu każda ważna decyzja zmienia widoczny rezultat. Losowy zbiór pięciu ładnych rekordów mógłby ukryć większość błędów.
Uruchom blok tworzący tabele raz, w nowej sesji ćwiczeniowej. Kolejne zapytania korzystają z tych samych tabel tymczasowych. Nie uruchamiaj przygotowania w bazie produkcyjnej. Tutaj wszystko mieści się w pamięci i znika po zamknięciu połączenia.
-- example: fixture
CREATE TEMP TABLE customers (
  customer_id INTEGER PRIMARY KEY,
  name TEXT NOT NULL
);
CREATE TEMP TABLE orders (
  order_id INTEGER PRIMARY KEY,
  customer_id INTEGER NOT NULL,
  ordered_at TEXT NOT NULL,
  status TEXT NOT NULL,
  amount INTEGER
);
INSERT INTO customers VALUES
  (1, 'Ada'), (2, 'Ben'), (3, 'Celina'), (4, 'Dan');
INSERT INTO orders VALUES
  (101, 1, '2026-01-01', 'paid', 100),
  (102, 1, '2026-01-01', 'paid', 50),
  (103, 2, '2026-01-02', 'paid', 150),
  (104, 2, '2026-01-02', 'cancelled', 999),
  (105, 3, '2026-01-03', 'paid', NULL),
  (106, 3, '2026-01-03', 'paid', 0),
  (107, 1, '2026-02-01', 'paid', 200);
Daty mają jednolity format ISO i nie zawierają godzin ani stref czasowych. Przy takich założeniach porównanie tekstowe zachowuje kolejność dni. W realnym systemie ustalam typ czasu i strefę raportu. Eksport mieszający formaty dat przestałby spełniać założenia tego ćwiczenia.
Zakres czasu ustalam jako przedział z wyłączonym końcem
Wybieram rekordy od pierwszego stycznia włącznie do pierwszego lutego wyłącznie. Taki zapis jasno pokazuje granicę miesiąca. Gdy później pojawią się godziny, nie muszę zgadywać, ile dziewiątek dopisać po ostatniej sekundzie ostatniego dnia.
W naszym zbiorze powinno zostać pięć opłaconych zamówień. Cztery mają znaną kwotę. Suma znanych kwot wynosi trzysta, a średnia tych kwot siedemdziesiąt pięć. Zakup anulowany oraz lutowy nie należą do tej populacji. Te liczby zapisuję jako punkt odniesienia do dalszych kontroli.
Szczególnie pilnuję zgodności zakresu w podzapytaniu i zapytaniu zewnętrznym. Porównanie styczniowych zamówień ze średnią obejmującą także luty może być poprawną analizą, ale musi wynikać z pytania. Jeśli zakres zmienia się przypadkiem, otrzymuję inny wskaźnik bez żadnego błędu składni.
Podzapytanie dostarcza wartość do porównania
Chcę zobaczyć znane kwoty większe od średniej w wybranej populacji. Najpierw nazywam tę populację w CTE, a następnie używam podzapytania skalarnego w warunku. Wynik średniej jest jedną wartością, więc można porównać z nim każdą kwotę.
-- example: above-average
WITH paid AS (
  SELECT * FROM orders
  WHERE status = 'paid'
    AND ordered_at >= '2026-01-01'
    AND ordered_at < '2026-02-01'
)
SELECT order_id, amount
FROM paid
WHERE amount > (SELECT AVG(amount) FROM paid)
ORDER BY order_id;
Otrzymuję zamówienie 101 z kwotą sto i zamówienie 103 z kwotą sto pięćdziesiąt. AVG pomija NULL, ale uwzględnia zero. Brak kwoty nie przechodzi warunku porównania. Zasady agregatów opisuje dokumentacja SQLite.
Ten przykład odpowiada na pytanie o pojedyncze zamówienia. Gdybym chciał znaleźć klientów powyżej średniej wartości klienta, musiałbym najpierw policzyć wartości klientów. Zmiana poziomu analizy wpływa na mianownik średniej. Użycie tej samej funkcji nie oznacza automatycznie odpowiedzi na to samo pytanie biznesowe.
CTE nazywa etap w obrębie jednego polecenia
WITH paid AS (...) pozwala mi raz zdefiniować wybraną populację i później się do niej odwoływać. CTE żyje w obrębie pojedynczego polecenia. Kolejne niezależne zapytanie potrzebuje własnej definicji. Nie traktuję go jak zapisanej na stałe tabeli z wynikami.
Największą korzyścią na tym etapie jest czytelność. Mogę nazwać kolejne kroki paid, totals i ranked, zamiast zagnieżdżać kilka wielkich bloków bez wyraźnego celu. Dobra nazwa mówi, co już zostało policzone, i pomaga sprawdzić poziom szczegółowości każdego wyniku pośredniego.
Sam zapis CTE nie dowodzi, że silnik wykona etap tylko raz ani że zrobi to szybciej. Dokumentacja WITH opisuje również wskazówki materializacji i rolę optymalizatora. Najpierw używam CTE do organizacji rozumowania. O wydajności mówię dopiero po obejrzeniu planu i wykonaniu pomiaru na reprezentatywnych danych.
Agreguję zamówienia przed dołączeniem klientów
Buduję podsumowanie zamówień na klienta. Dopiero potem dołączam je do pełnej listy klientów. Dzięki temu jedna strona złączenia ma jeden wiersz na klienta i druga również. Oczekiwana liczba wierszy wyniku jest łatwa do sprawdzenia.
-- example: summary
WITH totals AS (
  SELECT customer_id, COUNT(*) AS order_count,
         COUNT(amount) AS known_count, SUM(amount) AS known_total
  FROM orders
  WHERE status = 'paid'
    AND ordered_at >= '2026-01-01'
    AND ordered_at < '2026-02-01'
  GROUP BY customer_id
)
SELECT c.customer_id,
       COALESCE(t.order_count, 0) AS order_count,
       COALESCE(t.known_count, 0) AS known_count,
       COALESCE(t.known_total, 0) AS known_total
FROM customers AS c
LEFT JOIN totals AS t ON t.customer_id = c.customer_id
ORDER BY c.customer_id;
Wynik to kolejno: Ada ma dwa zamówienia, dwie znane kwoty i sumę sto pięćdziesiąt. Ben ma jedno, jedną i sto pięćdziesiąt. Celina ma dwa, jedną i zero. Dan ma wszędzie zero. Wartość Celiny opisuje sumę znanych kwot, a nie potwierdzoną pełną wartość jej zamówień.
COUNT(*) liczy rekordy w grupie, a COUNT(amount) tylko rekordy z niepustą kwotą. Różnica obu liczników ujawnia braki. COALESCE służy tutaj prezentacji, ale nie może zastąpić tej kontroli. Gdy wszystkie kwoty są nieznane, zero w kolumnie sumy bez licznika braków byłoby bardzo mylące.
JOIN potrafi zmienić znaczenie sumy
Wyobraź sobie dodatkową tabelę tagów klienta. Ada ma dwa tagi, Ben jeden. Jeśli przed agregacją połączę zamówienia z tagami, każde zamówienie Ady pojawi się dwa razy. Kwota będzie wyglądała poprawnie w każdym wierszu, a suma przestanie opisywać sprzedaż.
W takim przypadku zaczynam od pytania, po co potrzebuję tagów. Jeśli chcę tylko sprawdzić obecność określonego tagu, mogę użyć warunku istnienia. Jeśli potrzebuję raportu według tagów, muszę ustalić zasady przypisania wartości do wielu kategorii. Suma kategorii nie zawsze będzie wtedy równa sumie globalnej.
Nie naprawiam takiego problemu przez automatyczne dodanie DISTINCT do kwoty. Dwa różne zamówienia mogą mieć tę samą wartość i oba powinny zostać policzone. Dokładne przykłady mnożenia rekordów pokazuję w artykule o rodzajach JOIN. Tutaj zabezpieczeniem jest świadome agregowanie do odpowiedniego poziomu przed złączeniem.
Ranking wymaga decyzji o remisach i brakach
Do rankingu dopuszczam klientów mających opłacone zamówienia i kompletne kwoty. HAVING odrzuca grupy z brakami. Następnie funkcja okna nadaje rangę według sumy, a ostatni etap wybiera pierwsze miejsce. Każdy etap ma już inne, wyraźnie określone zadanie.
-- example: ranking
WITH totals AS (
  SELECT customer_id, SUM(amount) AS total
  FROM orders
  WHERE status = 'paid'
    AND ordered_at >= '2026-01-01'
    AND ordered_at < '2026-02-01'
  GROUP BY customer_id
  HAVING COUNT(amount) = COUNT(*)
), ranked AS (
  SELECT customer_id, total,
         RANK() OVER (ORDER BY total DESC) AS position
  FROM totals
)
SELECT customer_id, total, position
FROM ranked
WHERE position = 1
ORDER BY customer_id;
Ada i Ben dostają rangę jeden przy sumie sto pięćdziesiąt. Celina odpada z powodu niepełnych kwot. Dan nie ma zamówień, więc w ogóle nie trafił do agregacji. Wykluczenie z rankingu powinno być opisane obok raportu, aby czytelnik nie pomylił go z wynikiem zerowym.
RANK zostawia przerwy po remisach, a DENSE_RANK ich nie zostawia. Dla samego pierwszego miejsca dają ten sam zestaw liderów. ROW_NUMBER nadaje kolejne numery i przy wyborze jedynki zostawi jeden rekord. Jeśli naprawdę potrzebuję jednego zwycięzcy, ustalam dodatkową regułę, na przykład wcześniejszą datę spełnienia warunku.
Filtr przed oknem zmienia populację obliczenia
Dodanie unikalnego identyfikatora do porządku rankingu rozstrzygnęłoby remis. Nie byłoby jedynie uporządkowaniem wyświetlania. Dlatego miarę biznesową zostawiam w definicji rangi, a klientów o równej randze porządkuję osobnym końcowym sortowaniem. Taką różnicę łatwo przypadkiem usunąć podczas porządkowania kodu.
W SQLite nie filtruję wyniku funkcji okna przez WHERE w tym samym poziomie zapytania. Najpierw obliczam okno w CTE lub podzapytaniu, a potem wybieram wiersze w zewnętrznym zapytaniu. To rozdzielenie porządkuje również znaczenie analizy.
Jeżeli przed nadaniem rang ograniczę klientów do jednego regionu, otrzymam ranking tego regionu. Jeśli najpierw policzę ranking globalny, a region wybiorę później, zobaczę globalne pozycje klientów z tego regionu. Obie odpowiedzi mogą być potrzebne, ale odpowiadają na inne pytania.
Podobnie działa ograniczenie dat przy sumie narastającej. Usunięcie wcześniejszych miesięcy przed oknem sprawi, że suma zacznie się od początku widocznego okresu. Gdy raport ma pokazywać saldo uwzględniające historię, potrzebuję wcześniejszych rekordów albo osobnego salda otwarcia. Kolejność filtrów jest częścią definicji wskaźnika, a nie kosmetyką kodu.
Suma narastająca potrzebuje jednoznacznego porządku
Teraz zachowuję pojedyncze zamówienia ze znaną kwotą i dopisuję do każdego sumę od początku wybranego okresu. Sortuję według daty oraz identyfikatora. Druga kolumna rozstrzyga kolejność dwóch zamówień z tego samego dnia.
-- example: cumulative
SELECT order_id, amount,
       SUM(amount) OVER (
         ORDER BY ordered_at, order_id
         ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
       ) AS running_total
FROM orders
WHERE status = 'paid' AND amount IS NOT NULL
  AND ordered_at >= '2026-01-01'
  AND ordered_at < '2026-02-01'
ORDER BY ordered_at, order_id;
Kolejne sumy to sto, sto pięćdziesiąt, trzysta i trzysta. Ostatnie zamówienie ma kwotę zero, więc nie zwiększa sumy, ale pozostaje osobnym wierszem. Zamówienie z nieznaną kwotą jest wyłączone jawnie. Wynik opisuję jako narastającą sumę znanych kwot.
PARTITION BY customer_id pozwoliłoby rozpocząć obliczenie osobno dla każdego klienta. Tutaj celowo liczę jedną wspólną serię. Porządek wewnątrz okna określa obliczenie, natomiast końcowy ORDER BY określa kolejność wyświetlenia. Nie zakładam, że jedno automatycznie zastępuje drugie.
Domyślna rama może objąć cały remis
Przy agregacie okiennym z ORDER BY domyślna rama SQLite obejmuje także rekordy równorzędne według tego porządku. Gdy sortuję tylko po dacie, dwa zamówienia z pierwszego stycznia są równorzędne. Oba pokażą sumę sto pięćdziesiąt, nawet jeśli intuicyjnie oczekuję kroku po każdym zamówieniu.
-- example: frame-peers
SELECT order_id,
       SUM(amount) OVER (ORDER BY ordered_at) AS day_total
FROM orders
WHERE status = 'paid' AND amount IS NOT NULL
  AND ordered_at >= '2026-01-01'
  AND ordered_at < '2026-02-01'
ORDER BY ordered_at, order_id;
Wyniki to sto pięćdziesiąt, sto pięćdziesiąt, trzysta i trzysta. Wcześniejsza jawna rama ROWS z jednoznacznym porządkiem daje sumowanie rekord po rekordzie. Wersja z datą może być przydatna do pokazania sumy na koniec danego dnia, lecz nadal zachowuje pojedyncze zamówienia.
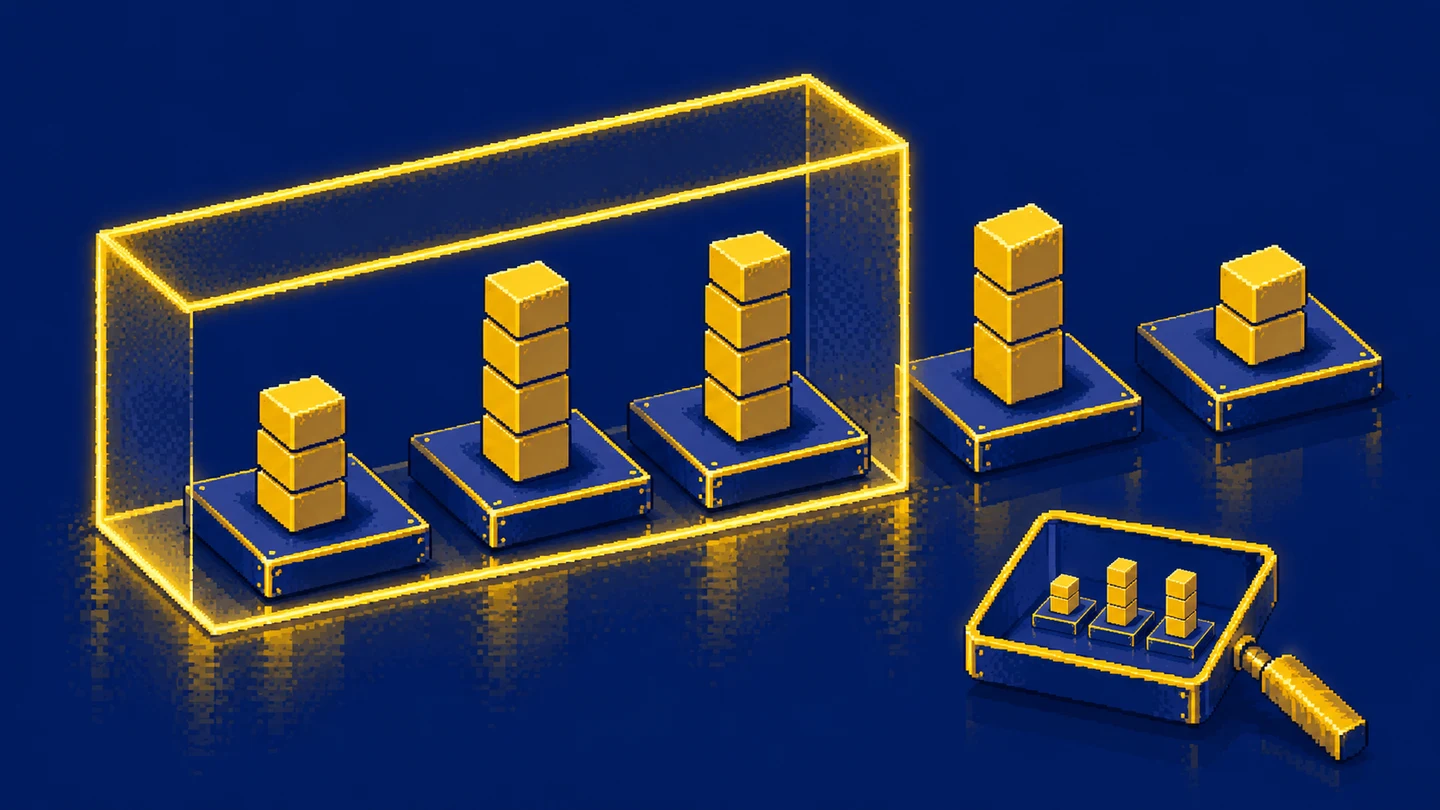
Różnice między ramami opisuje dokumentacja funkcji okna. Najpierw ustalam, czy chcę kroku po rekordzie, po dniu czy po grupie równych wartości. Potem dobieram zapis. Przy danych z remisami domyślne ustawienie szybko przestaje być niewinnym skrótem.
EXISTS odpowiada na pytanie o obecność
Gdy potrzebuję listy klientów z przynajmniej jednym opłaconym zamówieniem w styczniu, nie potrzebuję wszystkich par klient-zamówienie. Warunek EXISTS pozwala zapisać dokładnie to pytanie, zachowując jeden wiersz z zewnętrznej tabeli na klienta.
-- example: exists
SELECT c.customer_id
FROM customers AS c
WHERE EXISTS (
  SELECT 1 FROM orders AS o
  WHERE o.customer_id = c.customer_id
    AND o.status = 'paid'
    AND o.ordered_at >= '2026-01-01'
    AND o.ordered_at < '2026-02-01'
)
ORDER BY c.customer_id;
Wynik zawiera klientów jeden, dwa i trzy. Celina spełnia warunek, mimo że jedna kwota jest nieznana. Pytam o obecność opłaconego zamówienia, więc kompletność kwoty nie jest częścią tego filtra. Gdy zmieni się pytanie, zmienię warunek jawnie.
Nie obiecuję, że ta wersja zawsze wygra wydajnością z każdym poprawnie napisanym złączeniem. Jej zaletą w tym miejscu jest zgodność zapisu z zamiarem. Czytelny zamiar ułatwia kontrolę, a plan wykonania pokaże, jak silnik zrealizuje go na konkretnych danych.
Wydajność sprawdzam po poprawności
Na siedmiu zamówieniach niemal wszystko działa szybko. Taki zbiór służy kontroli logiki, nie porównaniu wydajności. Rzeczywisty pomiar wymaga reprezentatywnego wolumenu, rozkładu danych, indeksów i warunków wykonania. Podaję również, czy odczyt korzystał już z rozgrzanej pamięci podręcznej.
EXPLAIN QUERY PLAN pomaga zobaczyć sposób odczytu tabel i wykorzystanie indeksów. Nie traktuję planu jak stopera. Sam napis o użyciu indeksu nie gwarantuje szybszego wyniku, a pełny skan małej tabeli może być rozsądną decyzją optymalizatora.
W poprzedniej wersji tekstu pojawiał się dynamiczny SQL charakterystyczny dla SQL Servera. Tutaj go nie przenoszę do ćwiczenia SQLite. Zmienne wartości przekazuję przez parametry zapytania. Nazwy kolumn i kierunki sortowania wymagają odrębnego, kontrolowanego wyboru dopuszczalnych opcji. Parametr wartości nie jest uniwersalnym zamiennikiem fragmentu składni.
Sprawdź zapytania przez zmianę danych
Przed optymalizacją zapisuję oczekiwany wynik. Porównuję identyfikatory, liczbę rekordów i sumy, aby szybsza wersja nadal odpowiadała na to samo pytanie. Zapytanie może przyspieszyć tylko dlatego, że przypadkiem przestało uwzględniać część danych. Sam krótszy czas wykonania nie wystarcza do przyjęcia zmiany.
W pracy nad raportem dopisuję także krótki opis populacji obok tabeli wynikowej. Czytelnik powinien wiedzieć, jaki okres obejmuje raport, które statusy pomijam i ilu rekordom brakuje kwoty. Jeżeli ta informacja istnieje wyłącznie w komentarzu SQL, osoba oglądająca eksport do arkusza może nigdy jej nie zobaczyć. Wtedy technicznie poprawne obliczenie łatwo dostaje zbyt szeroką interpretację.
Przy przekazywaniu zapytania drugiej osobie proszę o ręczne policzenie jednego klienta. Wystarczą dwa zamówienia i jeden brak, żeby sprawdzić, czy rozumiemy definicję tak samo. Dopiero później porównuję sumy całego zbioru. Taka kontrola lokalnego fragmentu jest szczególnie przydatna, gdy dwie błędne operacje przypadkiem kompensują się w wyniku końcowym.
Dodaj klienta bez zamówień. Podsumowanie powinno dostać dodatkowy wiersz z zerowymi licznikami, a ranking pozostać bez zmian. Następnie zastąp brakującą kwotę Celiny wartością sto pięćdziesiąt. Jej kompletna suma zrówna się z wynikami Ady i Bena, więc ranking powinien pokazać trzech liderów.
Przywróć dane i usuń wszystkie zamówienia. Podsumowanie nadal powinno pokazać czterech klientów. Ranking, porównanie ze średnią i suma narastająca mają być puste. Potem usuń również klientów. Pusty wynik staje się wtedy poprawną odpowiedzią, a nie awarią do przykrycia sztucznym rekordem.
Sprawdź też rekord dokładnie z pierwszego lutego. Nie może wejść do stycznia. Te małe zmiany kontrolują granice, które w dużym raporcie łatwo przeoczyć. Jeśli chcesz następne zadanie z podobną dyscypliną, zbuduj histogram zamówień w SQL. Liczba użytych konstrukcji ma znaczenie dopiero wtedy, gdy potrafisz obronić wynik.
Najważniejsze w pigułce
Czy CTE przyspiesza zapytanie SQL?
CTE porządkuje zapis i pozwala nazwać etap analizy. Wydajność zależy od silnika, planu i danych. Sprawdzam plan oraz pomiar, zamiast obiecywać przyspieszenie przez samo dodanie WITH.
Czym funkcja okna różni się od GROUP BY?
GROUP BY tworzy wynik na poziomie grup. Funkcja okna oblicza wartość dla wiersza z użyciem powiązanych wierszy, zachowując poziom szczegółowości wejścia do tego etapu.
Jak zachować wszystkie pierwsze miejsca w rankingu?
Używam RANK albo DENSE_RANK po właściwej mierze i wybieram rangę 1. ROW_NUMBER wybiera jedną pozycję, więc potrzebuje świadomej reguły rozstrzygania remisów.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
