
KajoData / SQL
Star schema czy snowflake schema: jak zaprojektować model sprzedaży
Pokazuję oba układy na tych samych trzech pozycjach sprzedaży. Oddzielam szczegółowość danych od podziału wymiarów i wskazuję, co sprawdzić przed wyborem.
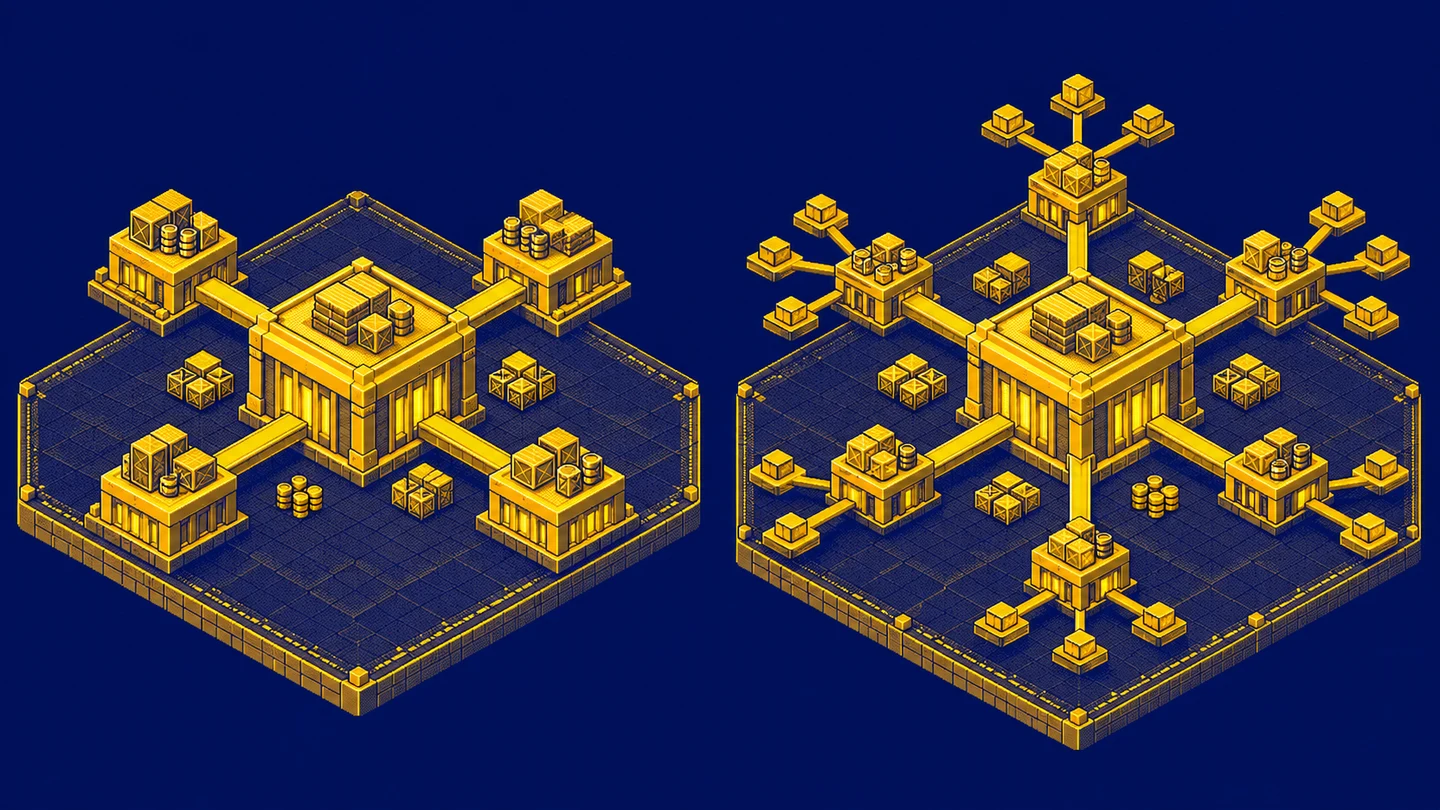
Na diagramie wszystko wygląda schludnie. Pośrodku sprzedaż, dookoła produkty, klienci i daty. Potem ktoś wydziela kategorię produktu do osobnej tabeli i zaczyna się rozmowa: czy właśnie zrobiliśmy model bardziej profesjonalny, czy tylko trudniejszy do użycia?
Ja zaczynam od pytania, co ma znaczyć jeden wiersz sprzedaży i jak odbiorca będzie ją analizował. Dopiero potem porównuję schemat gwiazdy i płatka śniegu. Oba mogą przechowywać te same szczegółowe zdarzenia. Sam kształt połączeń nie mówi jeszcze, czy raport odpowiada na właściwe pytanie.
Fakty i wymiary na prostym przykładzie
Tabela faktów przechowuje zdarzenia lub pomiary, a wymiar opisuje obiekty, według których chcemy je filtrować i grupować. W sprzedaży miarami mogą być ilość i wartość, a opisami nazwa produktu, kategoria czy miasto klienta. Ten podział przedstawia wprowadzenie Microsoft do schematu gwiazdy.
Nie rozpoznaję faktu tylko po obecności liczb. Numer klienta też jest liczbą, ale zwykle nie chcemy sumy numerów klientów. Z kolei fakt rejestrujący udział w wydarzeniu może nie mieć osobnej kwoty: policzymy wystąpienia. Rola tabeli wynika z jej znaczenia w analizie, a nie z samego typu kolumn.
W przykładzie przyjmuję fikcyjny sklep i trzy pozycje zamówień. Wszystkie kwoty są syntetyczne i wyrażone w tej samej umownej jednostce. Pomijam podatki, przeliczenia walut i zwroty, żeby pokazać konstrukcję modelu bez ukrytych założeń finansowych.
Najpierw ziarno tabeli faktów
Ziarno opisuje, co reprezentuje pojedynczy rekord. Tutaj będzie to jedna pozycja zamówienia. Zamówienie może mieć kilka pozycji, a produkt może wystąpić w wielu zamówieniach. Data jest dniem sprzedaży, zaś kwota wartością całej pozycji, już uwzględniającą jej ilość.
Dla czytelności zapisuję pozycję jako numer zamówienia i numer pozycji po ukośniku: 101/1 oznacza zamówienie 101, pozycję 1. Produkt to klucz product_key, sztuki to quantity, a kwota to sales_amount.
| Pozycja | Produkt | Sztuki | Kwota |
|---|---|---|---|
| 101/1 | 10 | 2 | 100 |
| 101/2 | 20 | 1 | 80 |
| 102/1 | 10 | 1 | 50 |
Obie pozycje zamówienia 101 należą do klienta o customer_key 1 i daty o date_key 20260101. Pozycja zamówienia 102 należy do klienta 2 i daty 20260102. Klucze dat oznaczają odpowiednio 1 i 2 stycznia 2026 r. Te opisy pozostają takie same w obu wariantach modelu.
Mamy trzy pozycje, dwa zamówienia, cztery sztuki i wartość 230. Te liczby posłużą do kontroli kolejnych wariantów. Jeśli po zmianie modelu zniknie pozycja lub sprzedaż wzrośnie bez nowego zdarzenia, szukam przyczyny przed ocenianiem elegancji diagramu.
Znaczenie ziarna i rodzaje tabel opisuje dokumentacja faktów Microsoft Fabric. Kluczowe dla naszego przykładu jest zachowanie jednego poziomu szczegółowości. Nie dokładam do tej samej kolumny kwot raz z pozycji, a raz z całych zamówień, bo późniejsza suma policzyłaby część sprzedaży podwójnie.
Schemat gwiazdy: opisy produktu w jednym wymiarze
W gwieździe fakt sprzedaży łączy się bezpośrednio z wymiarem produktu. W jednej tabeli produktu umieszczam nazwę, kategorię i inne atrybuty potrzebne odbiorcy raportu. Nazwa kategorii może powtarzać się dla wielu produktów, przy zachowaniu unikalnego klucza produktu.
| product_key | product_name | category_name |
|---|---|---|
| 10 | Mug | Accessories |
| 20 | Notebook | Stationery |
| 30 | Bottle | Accessories |
Produkt 30 nie ma sprzedaży w naszym zakresie, ale nadal może należeć do wymiaru. Wymiar nie musi być listą wyłącznie aktywnych zdarzeń. Może reprezentować pełną ofertę, którą wykorzystamy do porównania produktów sprzedanych i niesprzedanych.
Pozostałe ramiona gwiazdy stanowią klient i data. Nie kopiuję wszystkich ich opisów do każdej pozycji sprzedaży. Fakt przechowuje klucze, a powiązane tabele nadają im kontekst. Dlatego gwiazda nie oznacza jednej ogromnej tabeli z powielonym adresem klienta przy każdym zakupie.
Schemat płatka śniegu: osobna kategoria
W wariancie snowflake przenoszę kategorię do osobnej tabeli. Produkt zawiera klucz kategorii, a tabela kategorii zawiera jej opis. Ścieżka od sprzedaży do nazwy kategorii przechodzi teraz przez produkt. Ten wzorzec rozdzielania opisów wymiaru na powiązane tabele nazywamy normalizacją wymiaru.
| product_key | product_name | category_key |
|---|---|---|
| 10 | Mug | 1 |
| 20 | Notebook | 2 |
| 30 | Bottle | 1 |
| category_key | category_name |
|---|---|
| 1 | Accessories |
| 2 | Stationery |
Sprzedaż nadal ma dokładnie te same trzy pozycje i kwotę 230. Wyodrębnienie kategorii nie dodało transakcji ani nie usunęło szczegółów. Różnica dotyczy tego, gdzie mieszkają atrybuty i jak dochodzimy do nich podczas analizy.
Nazwę snowflake schema odróżnij od produktu Snowflake, czyli platformy danych. Schemat można zbudować w różnych systemach. Samo korzystanie z konkretnej platformy nie zmusza do modelu płatka śniegu, tak jak nazwanie tabeli „gwiazda” nie zapewnia poprawnych relacji.
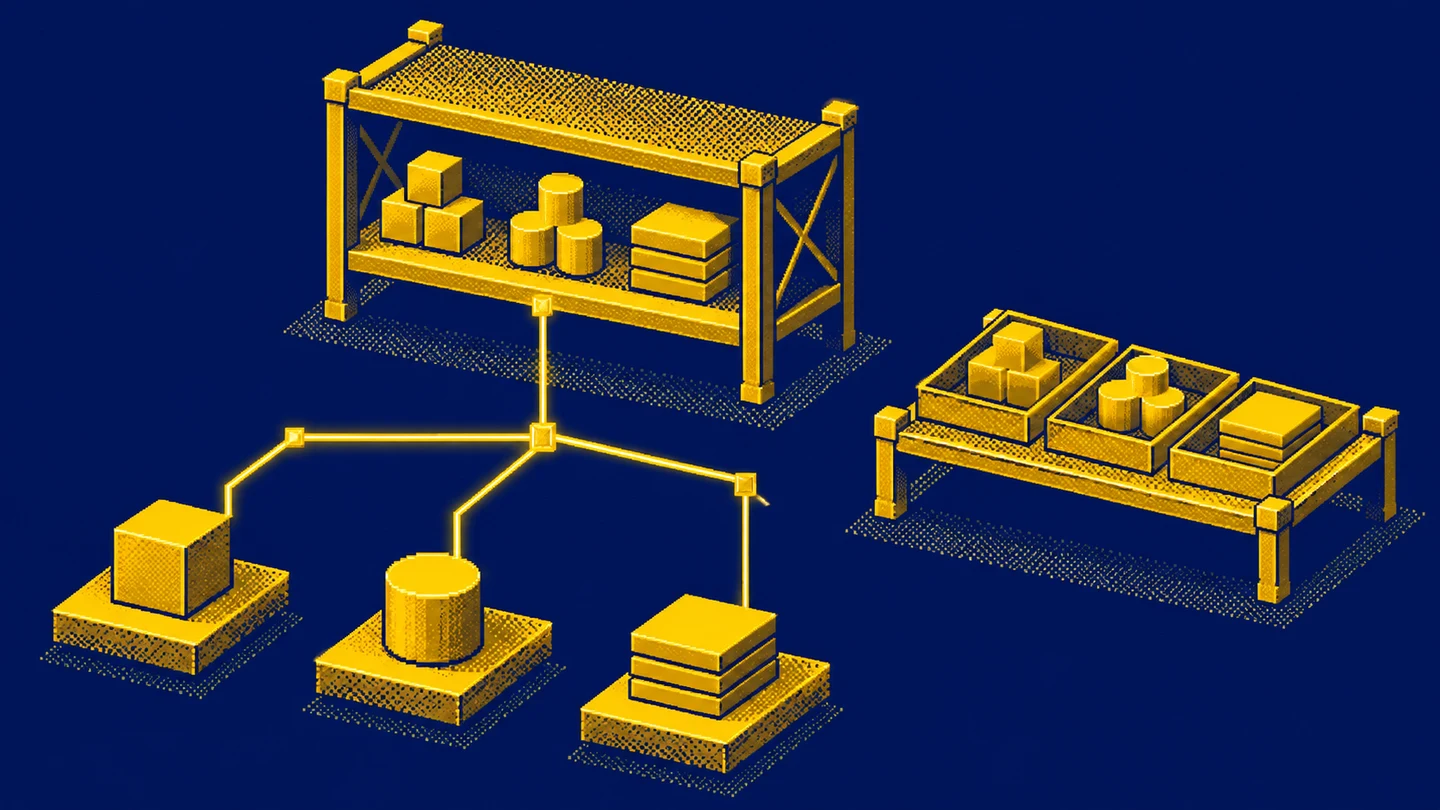
Brak pozycji sprzedaży nie musi oznaczać pomiaru równego zero. Dla produktu bez zdarzeń ustal, czy raport ma pokazać zero, pustą wartość czy brak wiersza. To reguła prezentacji i kompletności zakresu, którą warto opisać niezależnie od rozmieszczenia wymiarów.
Ten sam raport w obu układach
Pytanie brzmi: jaka jest sprzedaż według kategorii? W gwieździe łączę sprzedaż z produktem i grupuję po kategorii produktu. W płatku śniegu dochodzi przejście od produktu do tabeli kategorii. Zakładam po jednym dopasowaniu po każdej stronie opisowej.
Dla Accessories biorę pozycje produktu 10: 100 oraz 50, razem 150. Dla Stationery biorę 80. Produkt Bottle nie wnosi sprzedaży, ponieważ nie ma jego pozycji w tabeli faktów. Wynik 150 i 80 uzyskam w obu poprawnie powiązanych wariantach.
To dobry przykład do rozmowy z odbiorcą. Mogę pokazać, że zmiana rozmieszczenia kategorii zachowuje wynik i szczegółowość. Jeżeli odbiorca potrzebuje numeru zamówienia i konkretnej pozycji, oba układy nadal mają te dane. Normalizacja wymiaru nie jest automatycznym przejściem na bardziej drobne zdarzenia.
Powtórzony opis a powielony klucz
W gwieździe nazwa Accessories występuje przy dwóch produktach. To oczekiwane powtórzenie atrybutu. Co innego, gdy product_key 10 występuje dwa razy bez uzasadnionej reguły wersji. Wtedy połączenie może dopasować tę samą pozycję sprzedaży do dwóch wierszy produktu.
Załóżmy omyłkowo dwa dopasowania produktu 10. Jego sprzedaż 150 pojawi się po połączeniu dwa razy, a sprzedaż produktu 20 pozostanie 80. Łączny wynik wzrośnie do 380. Taki problem dotyczy poprawności relacji; sama nazwa schematu go nie naprawia.
Podobna sytuacja może powstać w tabeli kategorii modelu snowflake. Jeżeli klucz kategorii nie jest jednoznaczny, dodatkowe połączenie powieli wkład. Dlatego sprawdzam unikalność kluczy i brakujące dopasowania na każdym odcinku ścieżki. Liczba tabel zwiększa liczbę miejsc wymagających zrozumienia.
Przy integracji kilku źródeł ustaliłbym również zakres unikalności klucza. Produkt numer 10 w sklepie A i produkt numer 10 w sklepie B mogą oznaczać zupełnie inne towary. Przeniesienie obu numerów do jednej kolumny bez rozpoznania źródła grozi błędnym przypisaniem opisów i kwot. Klucz zastępczy pomaga reprezentować rozpoznany obiekt w modelu, ale proces ładowania musi wiedzieć, z którym obiektem go łączy. Samo nadanie kolejnych numerów nie rozwiązuje dopasowania produktów między systemami. To dodatkowa decyzja niezależna od wydzielenia tabeli kategorii.
Historia zmiany kategorii jest osobną decyzją
Wyobraź sobie, że Mug od lutego należy do innej kategorii. Czy styczniową sprzedaż pokazujemy według dzisiejszego podziału, czy według przypisania z chwili sprzedaży? Obie potrzeby występują w raportach, ale wymagają jawnej reguły. Samo wydzielenie tabeli kategorii nie zapisuje historii.
Nadpisanie opisu w wymiarze odpowiada podejściu SCD typu 1. Tworzenie kolejnych wersji wymiaru odpowiada typowi 2. Dokumentacja projektowania wymiarów opisuje klucze zastępcze i okresy obowiązywania wersji. Wersjonowanie musi współpracować z ładowaniem faktów, żeby zdarzenie wskazywało odpowiedni kontekst.
Dla naszego sklepu zapisałbym wymaganie przed wyborem układu: „raport historyczny zachowuje kategorię obowiązującą w dniu sprzedaży”. Potem sprawdziłbym przypadek styczniowego i lutowego zakupu tego samego produktu. Jeśli oba dostają dzisiejszą kategorię, model nie spełnia tego wymagania, choć wszystkie połączenia technicznie działają.
Gwiazda w Power BI i model w hurtowni
Warstwa przechowująca i przygotowująca dane nie musi mieć identycznego układu jak warstwa udostępniana autorom raportów. Możesz utrzymywać oddzielne tabele źródłowe, a do modelu semantycznego dostarczyć jeden wygodny wymiar produktu. Nie wymaga to udawania, że źródło miało inną strukturę.
Microsoft wskazuje w zaleceniach Power BI, że połączenie tabel wymiaru często poprawia wygodę użycia i skraca ścieżki filtrowania. Wybór zależy jednak od danych i wymagań. To wskazówka dla konkretnej warstwy analitycznej, a nie dowód, że każda normalizacja w każdym systemie jest pomyłką.
Ja patrzę również na osobę budującą wizualizację. Czy potrafi znaleźć kategorię, nazwę produktu i miarę sprzedaży? Czy rozumie, którą datę wybiera? Model, który wymaga zgadywania przy każdym przeciągnięciu pola, przenosi koszt technicznej decyzji na codzienną pracę użytkownika.
Wydajność i miejsce wymagają konkretnego pomiaru
Osobna tabela kategorii ogranicza powtarzanie jej opisu. Dodaje też klucze i relacje. Bilans miejsca zależy od liczności, szerokości atrybutów i sposobu przechowywania. Trudno uczciwie przeliczyć go z samego rysunku, szczególnie gdy silnik kompresuje powtarzający się tekst.
Więcej połączeń może oznaczać więcej pracy, ale rzeczywisty koszt zależy od silnika i zapytań. Nie podaję tu procentowej przewagi żadnego wariantu. Model z dobrze dobranym ziarnem może obsłużyć inne zapytania niż model z droższymi szczegółami, co dodatkowo utrudnia przypadkowe porównania szybkości.
Do porównania wybrałbym te same pytania i ten sam zakres zdarzeń. Sprawdziłbym sprzedaż według kategorii, filtrowanie pojedynczego produktu i wynik miesięczny. Uwzględniłbym czas odświeżenia oraz koszt utrzymania. Jedno szybkie otwarcie pustego raportu nie wystarcza do oceny całego rozwiązania.
Kilka faktów i relacje wiele do wielu
Większy model może zawierać sprzedaż pozycji, miesięczne plany i dzienne stany zapasu. Te fakty mają różne ziarno. Nie łączę planu miesięcznego bezpośrednio z każdą pozycją tylko dlatego, że obie tabele mają kod produktu. Taki ruch może wielokrotnie powtórzyć plan.
Wspólne wymiary pomagają analizować kilka faktów w spójnym kontekście. Nadal trzeba uwzględnić poziom, na którym istnieje dana miara. Miesięczny plan produktu nie staje się dziennym planem klienta po dodaniu dwóch filtrów. Potrzebna byłaby osobna reguła podziału, którą należy nazwać i uzgodnić.
Jeżeli produkt może należeć do wielu kategorii jednocześnie, prosty przykład jednej kategorii przestaje wystarczać. Wskazówki Microsoft o relacjach wiele do wielu omawiają tabele pomostowe. Trzeba zdecydować, czy pokazujemy pełną sprzedaż w każdej kategorii, czy ją rozdzielamy. Suma kategorii może wtedy wymagać innej interpretacji niż w naszym przykładzie.
Kierunek filtrów nie wynika z ładnego diagramu
W Power BI relacja określa także przepływ filtrów. Prosta ścieżka od kategorii przez produkt do faktu musi rzeczywiście przenieść wybór do miary. Samo narysowanie połączeń nie potwierdza tego zachowania. Sprawdziłbym filtr Accessories i oczekiwane 150, a potem filtr Stationery i 80.
Nie włączałbym wszystkich kierunków filtrowania tylko dlatego, że jeden wykres nie reaguje. Microsoft zaleca ograniczanie relacji dwukierunkowych, ponieważ mogą komplikować działanie modelu. Najpierw odczytaj istniejącą ścieżkę i upewnij się, że tabela pełni zakładaną rolę.
Dobra kontrola obejmuje również wyczyszczenie filtrów. Wynik powinien wrócić do 230, jeśli nie działają inne warunki zakresu. Odbiorca potrzebuje przewidywalnej nawigacji między całością a szczegółem. Przypadkowy zestaw relacji potrafi dać poprawny jeden ekran i mylący drugi.
Jak podejmuję decyzję o układzie
Dla prostego modelu raportowego zacząłbym od gwiazdy z czytelnymi wymiarami. Osobne tabele wymiaru rozważyłbym wtedy, gdy istnieje konkretna potrzeba ich współdzielenia, utrzymywania lub niezależnego przetwarzania. Zapisałbym korzyść oraz koszt dodatkowej ścieżki. Sama chęć zmniejszenia liczby powtórzonych słów to słaby opis wymagania.
Rozdzieliłbym również decyzję o modelu semantycznym od przebudowy źródła. Czasem wystarczy przygotować wygodny widok dla raportu. Czasem potrzebna jest zmiana procesu ładowania i obsługi historii. To różny zakres pracy, mimo że na końcu powstaje podobny prostokąt podpisany jako wymiar produktu.
Przy przekazaniu modelu opisałbym ziarno każdej tabeli faktów, klucze wymiarów, regułę historii i znaczenie kwot. Te informacje pomagają kolejnemu analitykowi bardziej niż etykieta „model zoptymalizowany”. Pozwalają też ocenić, czy nowy atrybut można bezpiecznie dodać do istniejącego wymiaru.
Sama poprawna relacja nie wybiera agregacji
W naszym przykładzie quantity oznacza sztuki, a sales_amount wartość całej pozycji. Mogę zsumować kwoty trzech pozycji, bo dotyczą tego samego rodzaju wartości i jednostki. Gdybym przechowywał cenę pojedynczej sztuki, musiałbym uwzględnić ilość. Dwa produkty po 50 na jednej pozycji dają 100 sprzedaży, a nie 50.
Nie sumowałbym cen jednostkowych tylko dlatego, że są kolumną liczbową w tabeli faktów. Podobnie procent marży nie nadaje się do zwykłego dodawania między pozycjami. Najpierw potrzebuję definicji licznika i mianownika oraz zasad agregowania. Wybór gwiazdy lub płatka nie usuwa odpowiedzialności za znaczenie miary.
Zwróć uwagę na liczenie zamówień. Trzy rekordy faktu oznaczają trzy pozycje. Zamówień są dwa. Jeżeli raport nazywa liczbę wierszy liczbą zamówień, będzie błędny w obu układach. Rozmowa o schemacie powinna więc obejmować przykładowe pytania, a nie kończyć się na ustaleniu, w której tabeli mieszka kategoria.
Co sprawdzam przy zmianie istniejącego modelu
Przy przenoszeniu kategorii zachowałbym mały zestaw oczekiwanych odpowiedzi: trzy pozycje, dwa zamówienia, cztery sztuki, 230 sprzedaży oraz podział 150 i 80. Nie wystarczy zgodność samej sumy końcowej. Dwa przeciwne błędy mogą się skompensować, a jedna kategoria może stracić sprzedaż na rzecz drugiej.
Porównałbym też produkt bez sprzedaży, brakujące dopasowanie i zmianę kategorii w czasie. Te przypadki ujawniają założenia, których nie widać w idealnym diagramie. Zapisuję, które rekordy powinny zostać i pod jaką etykietą. To pozwala odróżnić świadomą politykę braków od przypadkowego zniknięcia danych po dodatkowym połączeniu.
Na koniec sprawdziłbym, czy pola wybierane przez odbiorców nadal znaczą to samo. Zmiana technicznego układu może przenieść kategorię do innej tabeli, zostawić stare pole albo utworzyć dwie podobne etykiety. Dobrze przeprowadzona zmiana obejmuje czytelne nazwy i jednoznaczne wskazanie aktualnych pól. Użytkownik powinien móc odtworzyć wcześniejsze pytanie bez studiowania historii przebudowy.
Ćwiczenie: produkt bez kategorii
Dodaj sprzedaż produktu, którego nie ma jeszcze w wymiarze. Co powinien zobaczyć odbiorca: wiersz bez kategorii, specjalną kategorię brakującą czy odrzucone zdarzenie w raporcie jakości? Opisz oczekiwany wynik i sposób zachowania kwoty. Nie pozwól, żeby wybór INNER JOIN po cichu zdecydował o polityce braków.
Następnie dodaj nową kategorię do produktu Bottle, który nadal nie ma sprzedaży. Sprawdź, czy rozumiesz różnicę między katalogiem oferty a zbiorem zdarzeń. Oba zawierają przydatne informacje, lecz samo istnienie produktu nie tworzy wartości sprzedaży.
Jeżeli chcesz przećwiczyć zachowanie połączeń, przejdź do INNER JOIN i LEFT JOIN. W obu układach modelu przydadzą się te same podstawy: znaczenie klucza, liczba dopasowań i kontrola tego, co stało się z kwotą po połączeniu.
Najważniejsze w pigułce
Czy snowflake schema daje bardziej szczegółowe dane niż star schema?
Nie wynika to z samego układu. Szczegółowość faktów zależy od znaczenia jednego wiersza. Te same pozycje sprzedaży mogą działać w obu modelach.
Czy schemat gwiazdy musi mieć tylko jedną tabelę faktów?
Pojedynczą gwiazdę zwykle pokazuje się wokół jednej tabeli faktów. Większy model może zawierać wiele tabel faktów ze wspólnymi wymiarami i różnym ziarnem.
Czy schemat płatka śniegu jest zawsze wolniejszy?
Dodatkowe połączenia mogą zwiększać koszt, ale wynik zależy od silnika, danych, przechowywania i zapytań. Sam rysunek nie jest pomiarem wydajności.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
