
KajoData / SQL
LEFT JOIN w SQL: brakujące dopasowania i liczba wierszy
Pokażę, dlaczego trzech klientów daje cztery wiersze i jak zachować klientów bez zakupów, nie zawyżając liczby zamówień.
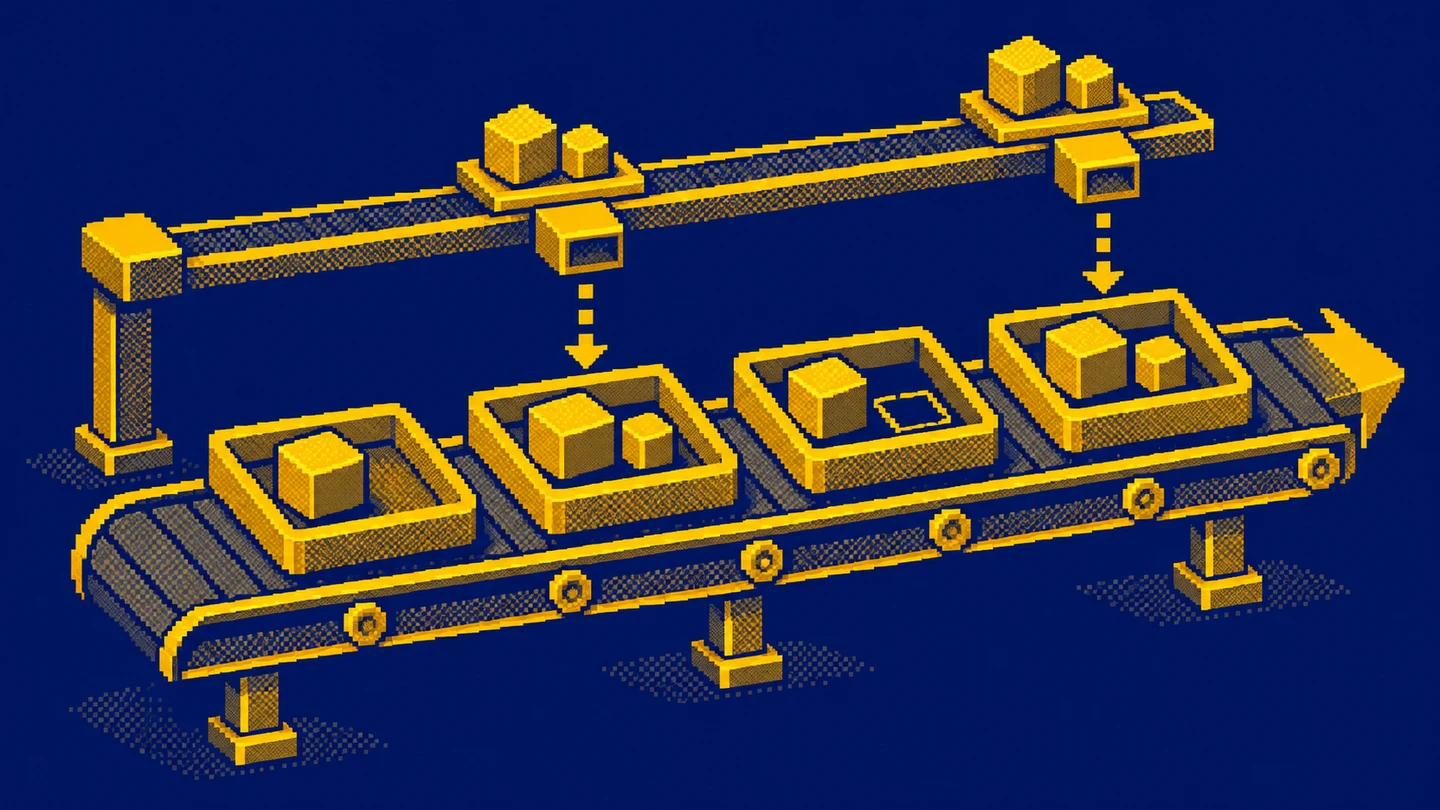
Masz listę klientów i chcesz dopisać do niej zamówienia. Wybierasz LEFT JOIN, bo klienci bez zakupów też mają zostać w raporcie. Po chwili okazuje się, że klientów było trzech, a w wyniku są cztery wiersze. Czy coś się zepsuło? Niekoniecznie. Jeden klient mógł złożyć dwa zamówienia.
Ja zaczynam takie łączenie od ustalenia, co ma przedstawiać jeden wiersz. Dopiero potem wybieram kolumny i liczę kwoty. Pokażę ten sposób na małych danych syntetycznych, które można przeczytać w całości. Przykłady dotyczą PostgreSQL 18, a kwoty oznaczają umowne jednostki. Nie potrzebujesz firmowej bazy, żeby zrozumieć, skąd bierze się każdy rekord.
Co zachowuje LEFT JOIN
LEFT JOIN łączy dwa źródła według warunku ON. Dla każdego wiersza lewego źródła pokazuje wszystkie pasujące wiersze prawego. Jeżeli żaden nie pasuje, dodaje jeden wiersz z wartościami NULL po prawej stronie. Słowo OUTER jest opcjonalne: LEFT JOIN i LEFT OUTER JOIN oznaczają ten sam rodzaj złączenia. Tak definiuje go dokumentacja PostgreSQL.
Zachowanie lewych wierszy nie oznacza zachowania ich liczby. Gdy klient ma pięć zamówień, otrzymasz pięć par klient i zamówienie. Gdy nie ma żadnego, otrzymasz jeden wiersz z pustą stroną zamówienia. Dopiero znajomość relacji pozwala przewidzieć rozmiar wyniku.
Ta gwarancja dotyczy samego złączenia. Późniejszy WHERE, grupowanie albo DISTINCT mogą zmienić wynik. Dlatego zdanie „LEFT JOIN zawsze zostawia wszystkich klientów” wymaga dopowiedzenia: po samym połączeniu, przed dalszymi operacjami. Za chwilę pokażę filtr, który usuwa klientów bez pasującego zamówienia.
Ustal źródło, od którego zaczynasz
W przykładzie customers zawiera trzech klientów. Każdy identyfikator występuje raz. Nazwa jest informacją do wyświetlenia, a identyfikator służy do połączenia.
| customer_id | customer_name |
|---|---|
| 1 | Ada |
| 2 | Ben |
| 3 | Celina |
Źródło orders zawiera trzy zamówienia. Ada ma dwa, Ben jedno, Celina żadnego. Każde zamówienie ma własny niepusty identyfikator.
| order_id | customer_id | amount | status |
|---|---|---|---|
| 101 | 1 | 100 | completed |
| 102 | 1 | 50 | pending |
| 103 | 2 | 80 | completed |
Pytanie brzmi: pokaż wszystkich klientów wraz z dostępnymi zamówieniami. Zaczynam więc od klientów po lewej. Gdybym zaczął od zamówień i dołączył klientów, zachowywałbym zbiór zamówień. To odpowiadałoby na inne pytanie, szczególnie przy danych, w których są brakujące powiązania.
W rzeczywistym raporcie spisałbym jeszcze zakres klientów: wszyscy historyczni, aktywni na dziś czy z określonego segmentu? LEFT JOIN nie rozstrzyga tej definicji. Zachowa zbiór, który mu podasz. Jeżeli wcześniej odfiltrujesz część klientów, nie odzyskasz ich samym wyborem rodzaju złączenia.
Jak przygotować dane do ćwiczeń
Poniższy fragment buduje dwa nazwane źródła za pomocą WITH i VALUES. Niczego nie zapisuje do trwałych tabel. W kolejnych przykładach przyjmuję te same dane; korzystając z tego fragmentu, zachowaj część WITH i wymieniaj końcowy SELECT. Nazwy CTE obowiązują w obrębie jednej instrukcji.
WITH customers(customer_id, customer_name) AS (
    VALUES (1, 'Ada'), (2, 'Ben'), (3, 'Celina')
), orders(order_id, customer_id, amount, status) AS (
    VALUES
        (101, 1, 100, 'completed'),
        (102, 1, 50, 'pending'),
        (103, 2, 80, 'completed')
)
SELECT c.customer_id, c.customer_name, o.order_id, o.amount
FROM customers AS c
LEFT JOIN orders AS o ON o.customer_id = c.customer_id
ORDER BY c.customer_id, o.order_id;
Dokumentacja VALUES opisuje taki sposób podawania wierszy. Używam go, żeby wszystkie założenia przykładu były widoczne. Nie musisz zgadywać, jakie rekordy kryją się poza zrzutem ekranu albo czy w źródle jest dodatkowy filtr.
Aliasy c i o skracają zapis. Dzięki prefiksowi widzę, z którego źródła pochodzi customer_id. Obie tabele mają kolumnę o tej nazwie, dlatego jawne wskazanie strony pomaga uniknąć niejednoznaczności. Alias nie zmienia danych ani reguły łączenia.
Przeczytaj cztery wiersze wyniku
| customer_id | customer_name | order_id | amount |
|---|---|---|---|
| 1 | Ada | 101 | 100 |
| 1 | Ada | 102 | 50 |
| 2 | Ben | 103 | 80 |
| 3 | Celina | NULL | NULL |
Ada pojawia się dwukrotnie, bo warunek ON pasuje do dwóch zamówień. Ben pojawia się raz. Dla Celiny nie ma dopasowania, więc PostgreSQL uzupełnia prawą stronę wartościami NULL. Wynik ma cztery wiersze i nadal obejmuje wszystkich trzech klientów.
Jeden wiersz oznacza teraz parę klient i zamówienie albo klienta bez dopasowania. Nie oznacza po prostu jednego klienta. Jeżeli policzysz wiersze i nazwiesz wynik „liczbą klientów”, otrzymasz cztery zamiast trzech. Problem leży w interpretacji poziomu szczegółowości.
Dodałem ORDER BY, żeby wynik można było jednoznacznie przeczytać. Sam JOIN nie gwarantuje kolejności. Nawet jeśli narzędzie przez kilka odświeżeń pokazuje ten sam układ, nie traktuję go jak umowy. Dokumentacja sortowania wskazuje ORDER BY jako sposób zagwarantowania porządku wyjścia.
Filtr w ON określa, co wolno dopasować
Załóżmy teraz, że interesują mnie wyłącznie zamówienia zakończone, ale nadal chcę widzieć wszystkich klientów. Dopisuję status do warunku połączenia.
SELECT c.customer_id, o.order_id
FROM customers AS c
LEFT JOIN orders AS o
    ON o.customer_id = c.customer_id
    AND o.status = 'completed'
ORDER BY c.customer_id, o.order_id;
Dostanę pary 1, 101, 2, 103 oraz 3, NULL. Zamówienie 102 nie spełnia warunku statusu, więc nie jest dopasowaniem. Celina nadal pozostaje w wyniku. Gdyby Ada miała wyłącznie zamówienie oczekujące, też zostałaby pokazana z NULL po stronie zamówienia.
Takie umiejscowienie filtra ma konkretne znaczenie: warunek definiuje zbiór kwalifikujących się powiązań. Klient bez zakończonego zamówienia ma zostać. Nie oznacza to automatycznie, że klient nigdy niczego nie zamówił. Może mieć zamówienie o innym statusie.
Ten sam warunek w WHERE zmienia pytanie
SELECT c.customer_id, o.order_id
FROM customers AS c
LEFT JOIN orders AS o ON o.customer_id = c.customer_id
WHERE o.status = 'completed'
ORDER BY c.customer_id, o.order_id;
Teraz wynik zawiera wyłącznie 1, 101 i 2, 103. Po złączeniu Celina ma NULL w kolumnie statusu. Porównanie z tekstem completed nie daje prawdy, więc WHERE odrzuca ten wiersz. Różnicę między warunkiem złączenia a filtrem wyniku pokazuje także sekcja WHERE w dokumentacji.
Nie naprawiam tego bez zastanowienia zapisem OR o.order_id IS NULL. Klient mający tylko zamówienie oczekujące ma rzeczywiste dopasowanie. Nie powstaje dla niego dodatkowy pusty wiersz, więc taki warunek nadal go usunie. Jeśli chcesz wszystkich klientów i tylko zakończone zamówienia, filtr statusu umieść w ON.
To dobry moment na powrót do pytania biznesowego. „Klienci z zakończonym zakupem” oraz „wszyscy klienci, z informacją o zakończonych zakupach” brzmią podobnie. Dają jednak różne zbiory. Ja wolę wyjaśnić tę różnicę przed budową wykresu.
Jak znaleźć klientów bez zamówień
SELECT c.customer_id, c.customer_name
FROM customers AS c
LEFT JOIN orders AS o ON o.customer_id = c.customer_id
WHERE o.order_id IS NULL
ORDER BY c.customer_id;
W naszym zbiorze zostanie Celina. Sprawdzam order_id, bo każde rzeczywiste zamówienie ma ten identyfikator. Gdybym sprawdzał amount IS NULL, mógłbym pomylić brak zamówienia z istniejącym zamówieniem o nieznanej kwocie.
W bazie produkcyjnej odpowiednim polem jest zwykle klucz główny prawej tabeli. Dokumentacja ograniczeń wyjaśnia, że PRIMARY KEY wymaga unikalności i braku NULL. Tego założenia nie przenoszę automatycznie na plik CSV, w którym kolumna tylko nazywa się id.
Alternatywą jest NOT EXISTS. Przydaje się szczególnie wtedy, gdy potrzebujesz wyłącznie odpowiedzi, czy powiązanie istnieje. Nie musisz dołączać wszystkich szczegółów zamówienia. Więcej o tym wyborze znajdziesz w poradniku o podzapytaniach.
COUNT gwiazdka i COUNT identyfikatora
Chcę otrzymać jeden wiersz na klienta i liczbę jego zamówień. Grupuję po identyfikatorze i nazwie, a następnie liczę niepuste identyfikatory zamówienia.
SELECT
    c.customer_id,
    c.customer_name,
    COUNT(o.order_id) AS order_count
FROM customers AS c
LEFT JOIN orders AS o ON o.customer_id = c.customer_id
GROUP BY c.customer_id, c.customer_name
ORDER BY c.customer_id;
Wyniki to Ada 2, Ben 1 i Celina 0. COUNT z wyrażeniem pomija NULL. COUNT(*) liczy wszystkie wiersze po złączeniu, więc dla Celiny dałby 1. Ten jeden wiersz reprezentuje klienta bez dopasowania, a nie rzeczywiste zamówienie. Obie postacie COUNT opisuje dokumentacja agregacji.
Przy sumowaniu pojawia się kolejne rozróżnienie. SUM dla Celiny zwróci NULL, bo nie ma niepustych kwot do dodania. Możesz uznać brak zamówień za obrót równy zero, ale zapisz tę decyzję świadomie. Istniejące zamówienia z brakującymi kwotami wymagają osobnej kontroli kompletności.
Zsumuj zamówienia przed dołączeniem innej relacji
Wyobraź sobie dodatkowe źródło kontaktów klienta. Ada ma dwa zamówienia i dwa numery kontaktowe. Gdy połączysz oba zbiory bezpośrednio przez klienta, każde zamówienie połączy się z każdym kontaktem. Z dwóch zamówień zrobią się cztery pary.
Kwoty 100 i 50 pojawią się po dwa razy. Suma wzrośnie ze 150 do 300, choć nie przybył żaden zakup. LEFT JOIN zachowuje wiersze, ale nie chroni przed takim zwielokrotnieniem. INNER JOIN też go nie rozwiąże. Potrzebujesz dopasować poziomy szczegółowości.
Jeżeli raport ma pokazywać klienta i jego obrót, najpierw zagreguj zamówienia do klienta. Kontakty też sprowadź do ustalonej postaci, na przykład jednego wybranego adresu według jawnej reguły. Dopiero te wyniki łącz. Samo nazwanie pola „główny kontakt” nie wybiera właściwego rekordu.
Nie używam SUM(DISTINCT amount) jako uniwersalnej poprawki. Dwa różne zamówienia mogą mieć identyczną kwotę. Usunięcie powtarzających się wartości kwoty usunęłoby wtedy poprawną część obrotu. Tożsamość zdarzenia wynika z klucza zamówienia, nie z jego ceny.
Klucz połączenia wymaga sprawdzenia
Równa nazwa kolumn nie dowodzi, że kolumny opisują to samo. Numer klienta z dwóch niezależnych systemów może wskazywać różne osoby. Nazwisko też nie jest bezpiecznym zamiennikiem identyfikatora. Dwie osoby mogą nazywać się tak samo, a jedna osoba może zmienić zapis nazwiska.
Przy źródle z historią klienta potrzebujesz dodatkowej reguły. Ten sam identyfikator może występować wielokrotnie, bo każdy wiersz opisuje inny okres. Dołączenie całej historii do bieżącego zamówienia może zwiększyć liczbę rekordów. Najpierw ustal, który okres ma odpowiadać dacie zdarzenia.
Sprawdzam też typ i znaczenie klucza. Tekstowy kod z początkowymi zerami może być czymś innym niż liczba. Dorysowanie zer podczas prezentacji nie odtwarza utraconej informacji w źródle. Regułę uzgadniania identyfikatorów warto ustalić przed połączeniem, zamiast ukrywać ją w przypadkowej konwersji.
NULL po lewej i po prawej stronie
Przy zwykłym porównaniu równości NULL nie dopasowuje się do NULL. Jeśli klient ma nieznany klucz i zamówienie też ma nieznany klucz, nie wynika z tego, że należą do siebie. Łączenie wszystkich brakujących kluczy mogłoby stworzyć wiele fałszywych par.
Dlatego w tym poradniku nie zastępuję brakujących identyfikatorów wspólnym zerem przed JOIN. Taki zabieg nadawałby różnym nieznanym obiektom jedną tożsamość. Jeżeli dane nie pozwalają rozstrzygnąć powiązania, wynik powinien tę niewiedzę pokazać. To cenna informacja o jakości źródła.
Podobnie odróżniam NULL w rzeczywistym zamówieniu od NULL dodanego przez złączenie. Do tego służy niepusty identyfikator prawej strony. Sama pusta nazwa produktu czy brakująca cena nie wystarczają do stwierdzenia, że zamówienia nie było.
Jeden wiersz na klienta przed kolejnym połączeniem
Poniżej sprowadzam zamówienia do poziomu klienta w osobnym podzapytaniu. Zakładam te same źródła customers i orders; przy korzystaniu z wcześniejszego WITH ten SELECT zastępuje jego końcową część.
SELECT
    c.customer_id,
    s.order_count,
    s.total_amount
FROM customers AS c
LEFT JOIN (
    SELECT
        customer_id,
        COUNT(*) AS order_count,
        SUM(amount) AS total_amount
    FROM orders
    GROUP BY customer_id
) AS s ON s.customer_id = c.customer_id
ORDER BY c.customer_id;
Dla Ady podzapytanie daje jeden wiersz z liczbą dwa i kwotą 150. Dla Bena daje jeden wiersz z liczbą jeden i kwotą 80. Dla Celiny nie ma w nim wiersza, bo źródło zamówień jej nie zawiera. Po złączeniu zobaczysz więc przy Celinie NULL w obu dołączonych kolumnach. To różnica względem wcześniejszego COUNT wykonywanego już po LEFT JOIN.
Jeśli potrzebujesz zera, możesz na zewnętrznym poziomie zastąpić brak licznika przez COALESCE(s.order_count, 0). W tym miejscu brak wiersza podsumowania oznacza brak zamówień. Dla kwoty nadal warto osobno uwzględnić sytuację, w której zamówienia istnieją, ale ich wartości są nieznane. Nie wyciągam takiego wniosku wyłącznie z pola total_amount.
Zaletą tej konstrukcji jest jawna umowa: podzapytanie zwraca najwyżej jeden wiersz na identyfikator klienta. Gdy dołączę je do unikalnej listy klientów, samo to połączenie nie zwiększy liczby klientów w raporcie. Jeśli później dołączę wiele kontaktów, poziom szczegółowości znowu się zmieni. Każdy kolejny JOIN wymaga własnej oceny.
Puste źródło też ma znaczenie
Wyobraź sobie, że lista zamówień jest pusta. LEFT JOIN z trzech klientów do tej listy nadal da trzy wiersze, po jednym na klienta, z NULL po prawej stronie. To pozwala przygotować raport również dla okresu bez sprzedaży. Nie trzeba dopisywać sztucznych zamówień o wartości zero.
Jeżeli pusta jest lista klientów po lewej, wynik również będzie pusty. Nawet pełna tabela zamówień po prawej niczego tu nie zachowa. To prosta kontrola, która pomaga wychwycić odwrócenie źródeł. Zawsze pytam, który zbiór ma wyznaczać populację raportu.
Dla porównania RIGHT JOIN odwraca stronę zachowywaną przez złączenie. Mogę zwykle przedstawić takie pytanie jako LEFT JOIN po zamianie źródeł miejscami. W praktyce wybieram zapis, w którym najłatwiej przeczytać intencję. Nie zakładam, że sama zamiana słowa kluczowego zapewnia inną wydajność.
Nie opisuj fizycznego algorytmu na podstawie składni
Czytając przykład, przechodzę kolejno przez klientów i ich dopasowania, bo tak łatwo wyprowadzić wynik ręcznie. To opis znaczenia operacji. Baza może wybrać inny fizyczny sposób wykonania: skorzystać z indeksu, haszowania albo innego planu. Tekst zapytania nie obiecuje prostej pętli po obu tabelach.
Gdy raport jest wolny, najpierw sprawdzam jego poprawność i liczbę tworzonych par. Niepotrzebne zwielokrotnienie może jednocześnie psuć sumy i zwiększać ilość pracy. Dopiero na poprawnym zapytaniu ma sens analiza planu. Dokumentacja EXPLAIN opisuje, jak odczytać plan wybrany przez PostgreSQL.
Nie podaję uniwersalnej obietnicy, że LEFT JOIN jest wolniejszy od INNER JOIN. Rodzaj połączenia wynika z potrzebnego wyniku. Usunięcie klientów bez zamówień w zamian za krótszy czas nie jest optymalizacją tego samego raportu, jeśli raport miał tych klientów obejmować.
Ćwiczenie: wszyscy klienci, tylko zakończone zakupy
Zmień zapytanie z COUNT tak, żeby liczyło wyłącznie zamówienia completed, zachowując wszystkich klientów. Najpierw wypisz oczekiwany wynik ręcznie. Ada ma jeden zakończony zakup, Ben jeden, Celina zero. Następnie umieść filtr statusu w ON i policz order_id.
Teraz dopisz do danych syntetycznych klienta Dana z jednym zamówieniem pending. On również powinien mieć zero zakończonych zakupów i nadal widnieć w raporcie. Ten przypadek odróżnia prawidłowy warunek ON od pozornie pomocnego filtra WHERE z dopisanym sprawdzeniem NULL.
Na końcu opisz jeden wiersz wyniku pełnym zdaniem. Jeśli potrafisz powiedzieć, jaki zbiór klientów zachowujesz, jakie zamówienia liczysz i dlaczego brak dopasowania daje zero, rozumiesz istotę tego raportu. Dalej polecam INNER JOIN oraz hasło COUNT.
Film o łączeniu danych
Zachowuję polski materiał KajoData opisany jako przykłady z MySQL. Zapytania w tym artykule dotyczą PostgreSQL 18 i stanowią samodzielne wyjaśnienie na jawnych danych syntetycznych.
Najważniejsze w pigułce
Czy LEFT JOIN zachowuje liczbę wierszy lewej tabeli?
Zachowuje każdy lewy wiersz, ale kilka dopasowań tworzy kilka wierszy wyniku. Późniejszy WHERE może część z nich usunąć.
Gdzie umieścić filtr prawej tabeli, żeby zachować wszystkich klientów?
W ON, jeśli filtr ma ograniczać dopasowywane zamówienia. Warunek w WHERE filtruje wynik połączenia i może odrzucić klientów bez dopasowania.
Dlaczego COUNT(*) daje jeden dla klienta bez zamówień?
Po LEFT JOIN taki klient ma jeden wiersz z NULL po prawej stronie. COUNT niepustego identyfikatora zamówienia zwróci dla niego zero.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
