
Baza wiedzy / SQL
EXCEPT w SQL: różnica zbiorów, duplikaty i NULL
EXCEPT porównuje całe wybrane wiersze. Wyjaśniam kolejność stron porównania, odejmowanie liczby kopii i pułapkę uznawania zmienionej nazwy za brak klienta.
Gdy porównuję dwa eksporty, najpierw ustalam znaczenie różnicy. Czy szukam identyfikatorów obecnych tylko w pierwszym pliku, zmienionych danych klienta, czy brakujących kopii zdarzenia? EXCEPT pomaga porównać wyniki zapytań, lecz wybór kolumn i wariantu operatora decyduje o odpowiedzi.
Kierunek porównania i wybrane kolumny
PostgreSQL opisuje EXCEPT jako różnicę wyników: wiersze z lewego zapytania, których nie ma po prawej, z domyślnym usunięciem duplikatów. Dla dwóch tabel z kolumną całkowitą customer_id mogę napisać:
SELECT customer_id
FROM previous_customers
EXCEPT
SELECT customer_id
FROM current_customers
ORDER BY customer_id;
To porównanie identyfikatorów z poprzedniego i obecnego eksportu. Odwrócenie tabel odpowie na inne pytanie: które ID są tylko w obecnym pliku. Dla pełnej kontroli różnic rozważyłbym oba kierunki, wyraźnie je nazywając. Pojedyncza różnica nie jest symetryczna.
Oba zapytania muszą zwracać tyle samo kolumn i zgodne typy na odpowiadających sobie pozycjach. Nie opierałbym porównania na SELECT *: zmiana układu tabeli może zmienić znaczenie zapytania albo spowodować błąd. Przy danych tekstowych trzeba też sprawdzić reguły porównania i collation używanego silnika.
Małe dane: zwykłe EXCEPT i EXCEPT ALL
Załóżmy dwie syntetyczne tabele left_ids i right_ids, każda z jedną kolumną całkowitą id. Powtórzenia są celowe. NULL oznacza brak wartości, a nie tekst składający się z czterech liter.
| Tabela | Zawartość kolumny id, z zachowaniem liczby kopii |
|---|---|
| left_ids | 10, 10, 10, 20, 20, NULL |
| right_ids | 10, 30, NULL |
Zapytanie bez ALL:
SELECT id FROM left_ids
EXCEPT
SELECT id FROM right_ids;
Wynik zawiera jeden wiersz z wartością 20. Dziesiątka jest obecna po obu stronach, więc nie zostaje w różnicy. Dwie kopie dwudziestki stają się jedną. Dwa braki również traktuje się jako odpowiadające sobie na potrzeby tego porównania zbiorowego; Microsoft opisuje tę regułę dla NULL.
W PostgreSQL mogę zachować znaczenie liczby wystąpień:
SELECT id FROM left_ids
EXCEPT ALL
SELECT id FROM right_ids
ORDER BY id;
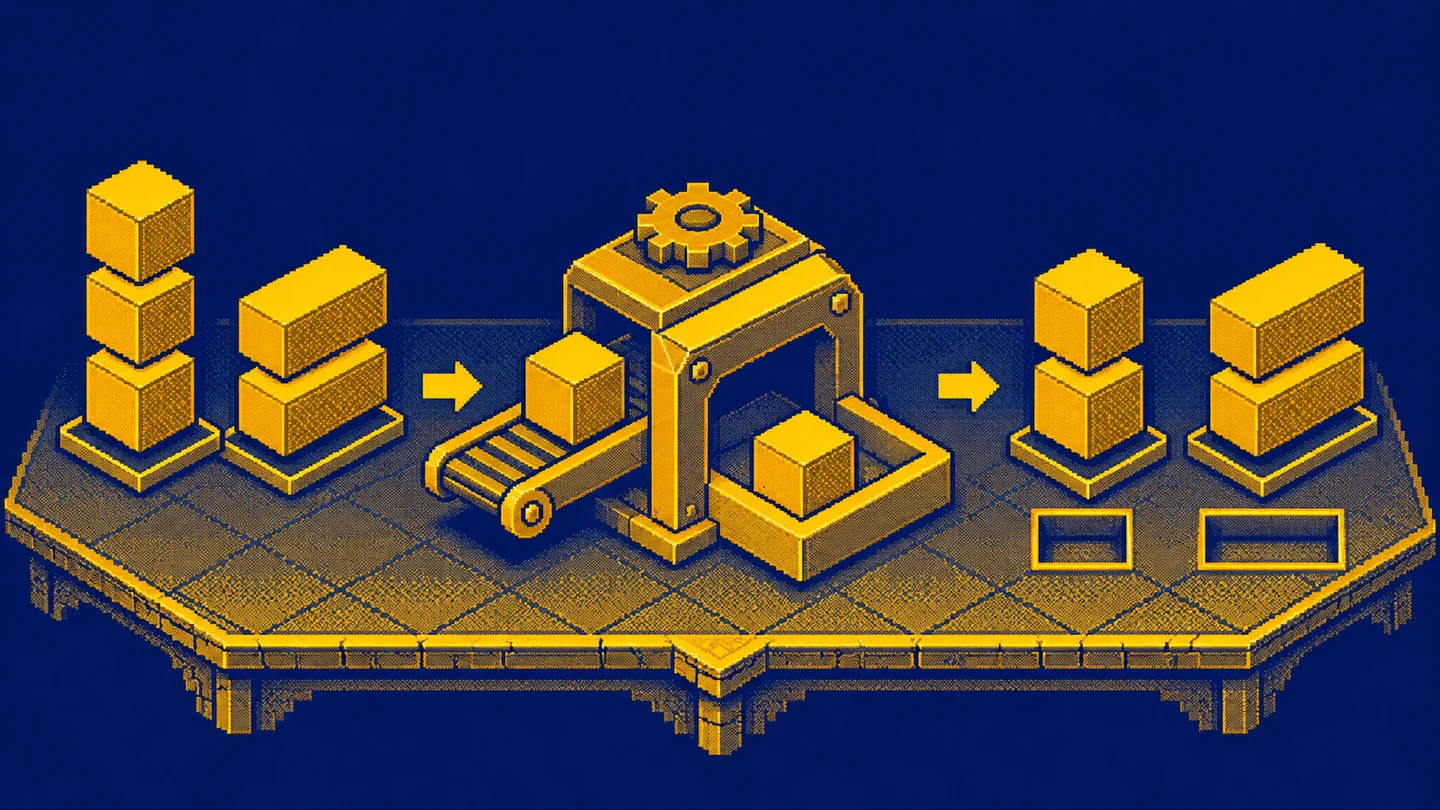
Tutaj wynik to 10, 10, 20, 20. Dla dziesiątki odejmujemy jedną kopię po prawej od trzech po lewej. Dwudziestka ma dwie kopie po lewej i zero po prawej. Braki występują po jednym razie, więc nie pozostaje żadna kopia NULL.
Dokumentacja PostgreSQL podaje regułę max(m - n, 0). To odejmowanie liczności. Wartość obecna po prawej nadal może pozostać w EXCEPT ALL, jeśli po lewej wystąpiła częściej. Nadmiar kopii po prawej nie tworzy ujemnej liczby wierszy.
Obsługa zależy od silnika i wersji
| Silnik | EXCEPT | EXCEPT ALL |
|---|---|---|
| PostgreSQL 18 | tak | tak |
| MySQL od 8.0.31, w tym 8.4 | tak | tak |
| SQL Server | tak | nie |
| SQLite | tak | nie |
| Oracle Database 21c | tak, także nazwa MINUS | tak, także MINUS ALL |
Dodanie operatorów do MySQL potwierdzają informacje o wydaniu 8.0.31, a bieżącą składnię dokumentacja MySQL 8.4. Starsze twierdzenie, że MySQL w ogóle nie obsługuje EXCEPT, prowadzi dziś do niepotrzebnych obejść.
Dla SQLite dostępna jest różnica z usuwaniem duplikatów, bez EXCEPT ALL. Dokumentacja Oracle 21c wymienia również EXCEPT i warianty ALL. Przy starszym wdrożeniu Oracle sprawdziłbym właściwą wersję zamiast zakładać identyczną listę operatorów.
Zmiana nazwy nie oznacza odejścia klienta
Przyjmijmy, że w poprzednim eksporcie jest wiersz (7, 'Firma A'), a w obecnym (7, 'Firma B'). Jeżeli porównasz customer_id, name, stara para pojawi się w różnicy. To dowód braku dokładnie tej pary wartości w drugim wyniku. Nie dowodzi, że klient o ID 7 zniknął.
Ja do sprawdzenia obecności wybrałbym samo ID. Zmiany atrybutów rozpatrzyłbym osobno po uzgodnieniu reguły porównania. Również brak ID w aktualnym pliku nie jest automatycznie dowodem odejścia klienta: eksport może obejmować inny filtr, okres lub moment odświeżenia. Operator ustala różnicę danych, a interpretacja nadal wymaga kontekstu.
NOT EXISTS wymaga świadomego porównania
W PostgreSQL odpowiednik zwykłego EXCEPT dla naszego pojedynczego pola można zapisać tak:
SELECT DISTINCT l.id
FROM left_ids AS l
WHERE NOT EXISTS (
    SELECT 1
    FROM right_ids AS r
    WHERE r.id IS NOT DISTINCT FROM l.id
)
ORDER BY l.id;
DISTINCT usuwa kopie po lewej, a porównanie IS NOT DISTINCT FROM pozwala dopasować również dwa braki. NOT EXISTS wybiera przypadki bez dopasowania w podzapytaniu. Sama równość r.id = l.id nie dopasuje dwóch NULL. Bez uwzględnienia obu tych różnic prosty antyjoin może oddać duplikaty i brak, których nie ma w wyniku EXCEPT.
Nie traktowałbym tego zapisu jako uniwersalnej recepty dla każdej wersji każdego silnika. Przed wyborem alternatywy sprawdziłbym składnię porównania odpornego na NULL i oczekiwaną liczność wyniku. Nie deklaruję też, że jedna metoda zawsze będzie szybsza. To wymaga oceny konkretnego zapytania, danych i planu.
Ćwiczenie
Dodaj w wyobraźni drugą dziesiątkę do right_ids. Zwykłe EXCEPT nadal zwróci tylko 20. W EXCEPT ALL pozostanie jedna dziesiątka i dwie dwudziestki. Następnie odwróć strony zwykłego porównania: wynikiem będzie 30. Dla części wspólnej zbiorów zajrzyj do hasła INTERSECT.
Najważniejsze w pigułce
Czy MySQL obsługuje EXCEPT?
Tak, od wersji 8.0.31, także z ALL. W starszym MySQL potrzebujesz innego zapisu, dobranego do oczekiwanego traktowania duplikatów i NULL.
Czy SQLite obsługuje EXCEPT ALL?
SQLite obsługuje EXCEPT usuwające duplikaty, ale nie ma wariantu EXCEPT ALL. Nie należy kopiować do niego tego wariantu z PostgreSQL.
Czy EXCEPT porównuje rekordy po kluczu?
Porównuje zestaw wybranych kolumn według ich pozycji. Jeżeli wybierzesz ID i nazwę, zmiana nazwy oznacza inny wiersz, nawet przy tym samym ID. Do szukania brakujących ID wybierz samo ID.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
