
Baza wiedzy / Python
DataFrame.join w pandas: indeksy, on i sufiksy
Pokazuję poprawny wynik left join i wybór klucza bez MultiIndex po lewej. Wyjaśniam również listę dołączanych obiektów oraz zmianę zapisu sufiksów od pandas 3.1.
Gdy klucz jest już indeksem, dołączenie kilku kolumn często wygodnie zapisuję jako left.join(right). Najpierw jednak sprawdzam, co indeks oznacza. Dwa pliki mogą mieć identyczne numery wierszy i zupełnie inną kolejność klientów. Technicznie udane połączenie takich tabel nie potwierdzi, że zestawiłem informacje dotyczące tej samej osoby lub produktu.
Właściwa nazwa interfejsu to DataFrame.join, metoda wywoływana na ramce danych. Nie używam zapisu pd.join(...). Poniższe przykłady są syntetyczne i opisane na podstawie dokumentacji. Główny przykład sufiksów stosuje aktualny zapis pandas 3.1; osobno pokazuję wariant dla wcześniejszych wersji 3.x. Kod w tekście służy nauce, bez deklaracji jego uruchomienia.
Zasada domyślnego połączenia
Dokumentacja DataFrame.join opisuje domyślne łączenie indeksu z indeksem i how='left'. To inny domyślny wybór niż inner w merge. Kiedy zależy mi na czytelności, wpisuję how jawnie nawet wtedy, kiedy zgadza się z wartością domyślną. Dzięki temu osoba czytająca kod od razu widzi, która tabela stanowi bazę.
Przy poprawnym słowniku po prawej lewa tabela zachowuje swoje wiersze i dostaje pasujące kolumny. Powtórzony klucz może jednak tworzyć kilka par, więc samo słowo left nie daje gwarancji niezmiennej liczby wierszy. Zaczynam od małego przykładu z unikalnymi indeksami, żeby oddzielić wybór populacji od problemu relacji między tabelami.
Poprawny przykład z nakładającymi się nazwami
import pandas as pd

left = pd.DataFrame({
    'A': ['A0', 'A1', 'A2'],
    'B': ['B0', 'B1', 'B2'],
}, index=[0, 1, 2])
right = pd.DataFrame({
    'B': ['B3', 'B4', 'B5'],
}, index=[1, 2, 3])

result = left.join(
    right,
    how='left',
    suffixes=('_left', '_right'),
    validate='one_to_one',
)| Indeks | A | B_left | B_right |
|---|---|---|---|
| 0 | A0 | B0 | brak |
| 1 | A1 | B1 | B3 |
| 2 | A2 | B2 | B4 |
Dla indeksu zero brak dopasowania po prawej. Dla jeden dostajemy B3, a dla dwa B4. Wiersz z indeksem trzy nie pojawia się, bo występuje tylko po prawej. Dawny tekst EN pokazywał go mimo domyślnego left, czyli opisywał wynik innego rodzaju połączenia. W tabeli słowo „brak” oznacza brakującą wartość, bez przywiązywania wyjaśnienia do formatowania wydruku.
Sufiksy w pandas 3.1 i starszych wersjach
Obie tabele mają kolumnę B. suffixes rozróżnia ją jako B_left i B_right, nie zmieniając klucza ani typu połączenia. Od pandas 3.1 dokumentacja oznacza parametry lsuffix i rsuffix jako przestarzałe. Przy utrzymywaniu kodu w pandas 3.0 spotkasz wcześniejszy zapis:
legacy_result = left.join(
    right,
    how='left',
    lsuffix='_left',
    rsuffix='_right',
    validate='one_to_one',
)
Sens dopasowania pozostaje taki sam. Wybierz zapis do używanej wersji biblioteki. Nie kopiuj nowego parametru do starszego środowiska bez sprawdzenia dostępności. Gdy kolumny mają odmienne znaczenie, ja rozważam też nadanie im opisowych nazw jeszcze przed połączeniem. Dzięki temu wynik pozostaje czytelny także poza miejscem, w którym zapisano operację.
Inner i outer na tych samych danych
common = left.join(right, how='inner', suffixes=('_left', '_right'))
all_keys = left.join(right, how='outer', suffixes=('_left', '_right'))
inner zachowa indeksy jeden oraz dwa. outer uwzględni zero, jeden, dwa i trzy. W dodatkowym wierszu trzy lewa kolumna A i lewa B będą brakujące, a prawa B przyjmie B5. Ten wiersz ma sens przy zachowaniu sumy zbiorów indeksów. Nie dopisuję go do tabeli opisującej left tylko dlatego, że widzę go w danych wejściowych po prawej.
W danych rzeczywistych typ połączenia wynika z pytania. Jeśli raport ma opisywać lewą populację, pozostanie przy left jest świadomym wyborem. Jeśli ma ujawnić wszystkie klucze z obu źródeł, potrzebuję szerszego zestawu. Żaden z wariantów sam nie powie, czy brak oznacza nieobecność zdarzenia, brak informacji czy problem przygotowania danych.
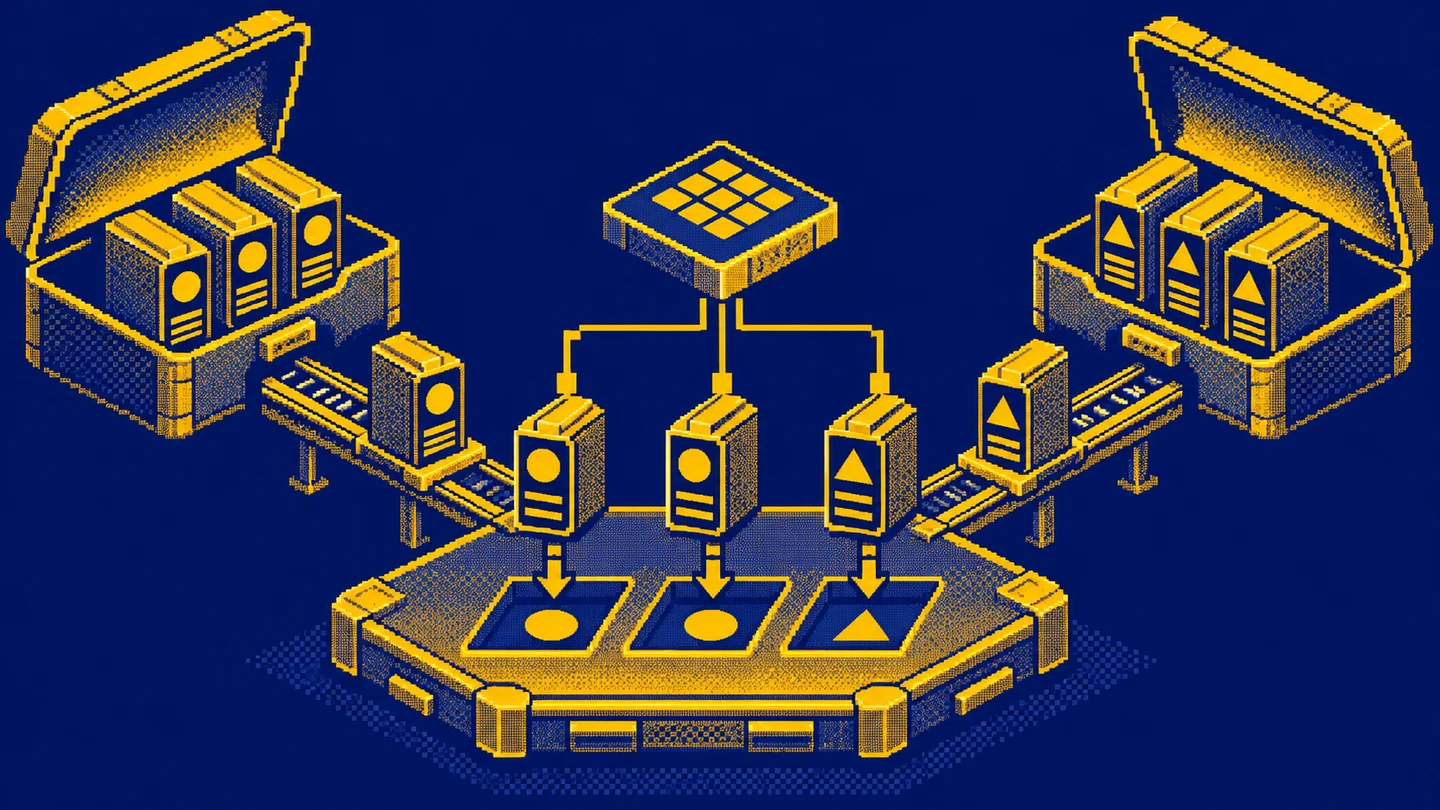
on łączy kolumnę po lewej z indeksem po prawej
Osobny przykład ma zwykłą kolumnę customer_id po lewej. Nie wymaga MultiIndex w tabeli zamówień:
orders = pd.DataFrame({
    'order_id': [101, 102, 103],
    'customer_id': [2, 1, 3],
})
lookup = pd.DataFrame({
    'customer_name': ['Ada', 'Ben'],
}, index=[1, 2])

enriched = orders.join(
    lookup,
    on='customer_id',
    how='left',
    validate='many_to_one',
)| Indeks lewej tabeli | order_id | customer_id | customer_name |
|---|---|---|---|
| 0 | 101 | 2 | Ben |
| 1 | 102 | 1 | Ada |
| 2 | 103 | 3 | brak |
Klient dwa trafia do Bena mimo pierwszej pozycji w tabeli zamówień. Klient jeden trafia do Ady, a trzy nie ma odpowiednika. Dopasowuję wartości customer_id do indeksu lookup. Nie porównuję dwóch kolumn o tej nazwie. Właśnie dlatego przed użyciem on trzeba sprawdzić prawą stronę. Dla kilku wskazanych pól prawa tabela potrzebuje odpowiedniego indeksu wielopoziomowego.
Jeżeli oba klucze są kolumnami i chcę zostawić je w takiej postaci, zwykle wybieram pandas.merge. Nie przypisuję join ogólnej przewagi wydajności. Czytelność zapisu zależy od struktury danych, a porównanie czasu wykonania potrzebowałoby konkretnego pomiaru w określonych warunkach.
Dołączenie listy obiektów
Argument other może być także listą ramek lub nazwanych serii. Nowy przykład wykorzystuje bazową kolumnę A oraz dwie różne informacje indeksowane tym samym sposobem:
base = left[['A']]
extra = right.rename(columns={'B': 'C'})
flags = pd.DataFrame({'reviewed': [True, False]}, index=[0, 2])
combined = base.join([extra, flags], how='left')
Wynik nadal obejmuje indeksy zero, jeden i dwa. Dla zero reviewed jest prawdą, a C brakuje. Dla jeden C ma B3, a flagi brakuje. Dla dwa C ma B4, a reviewed jest fałszem. Pojedyncza dołączana Series potrzebuje name, który stanie się nazwą kolumny. Lista obiektów nie oznacza, że można swobodnie mieszać klucze z różnych dziedzin.
Dla listy nie stosujesz on ani sufiksów. Dlatego nazwy przygotowałem wcześniej i nie pozostawiłem nakładających się kolumn. To istotne ograniczenie względem dołączenia jednego obiektu. Gdy kilka źródeł wymaga odmiennych warunków dopasowania, wolę osobne, czytelne kroki zamiast próby ukrycia całego procesu w jednym wywołaniu.
Co sprawdzić przed zaakceptowaniem wyniku
validate='many_to_one' w przykładzie zamówień kontroluje unikalność klucza po prawej. Nie potwierdza istnienia klienta trzy ani poprawności przypisanych nazw. Kontroluję więc także brak dopasowania i sens danych. Przewodnik pandas o łączeniu pomaga rozpoznać, kiedy powtórzenia klucza tworzą relację wiele do wielu, a kiedy wskazują problem modelu.
Uważam również na brakujące klucze. Semantyka dopasowania pandas może różnić się od zwykłego porównania NULL w SQL, co opisuje referencja merge. Jeśli indeks albo kolumna klucza ma braki, ustalam sposób ich obsługi przed łączeniem. Nie uznaję dwóch nieznanych identyfikatorów automatycznie za ten sam obiekt biznesowy.
Ćwiczenie z trzema decyzjami
W przykładzie zamówień zastanów się, czy chcesz zachować zamówienie klienta bez nazwy. Potem rozważ duplikat indeksu jeden w słowniku: jaka walidacja powinna go zatrzymać? Na końcu wybierz, czy klucz zostawić w kolumnie i użyć on, czy świadomie nadać mu rolę indeksu. Każda decyzja dotyczy znaczenia danych, więc warto umieć ją wyjaśnić przed wyborem składni.
Do podstaw indeksu wróć przez pandas.Series. Jeśli potrzebujesz ogólnego porównania operacji po kluczach i kontroli relacji, przejdź do merge. Spójny klucz i jasno określona populacja wyniku przydadzą się w obu zapisach.
Najważniejsze w pigułce
Czy istnieje funkcja pandas.join()?
Używany tutaj interfejs to metoda DataFrame.join, wywoływana na tabeli, na przykład left.join(right). Nie jest to funkcja pd.join.
Czy on wymaga MultiIndex po lewej?
Nie. Możesz wskazać zwykłą kolumnę lewej tabeli, która zostanie dopasowana do indeksu prawej. Przy kilku polach on prawa strona wymaga odpowiedniego MultiIndex.
Czy join przyjmuje tylko jeden DataFrame?
Nie. Można przekazać DataFrame, nazwaną Series albo listę takich obiektów. Dla listy nie używasz on ani sufiksów, więc nazwy kolumn trzeba przygotować wcześniej.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
