
KajoData / Praca i rozwój
Data Analyst vs Data Scientist: zadania, odpowiedzialność i wybór ścieżki
Na jednym przykładzie pokazuję, jak zmieniają się pytanie, rezultat i sposób sprawdzania pracy analityka oraz data scientist.
Data analyst czy data scientist? Zacząłbym od pytania, jaką pracę chcesz wykonywać, kiedy skończy się przeglądanie nazw kursów. W obu rolach można pisać kod, sprawdzać dane, rozmawiać z biznesem i prezentować wyniki. Różnica staje się wyraźniejsza, gdy ustalimy konkretny problem, oczekiwany rezultat i sposób sprawdzenia, czy rozwiązanie rzeczywiście pomaga.
Nie ustawiałbym tych nazw na jednej drabinie, po której każdy analityk powinien obowiązkowo wejść do data science. Można rozwijać się w analizie, projektowaniu miar, eksperymentach, modelowaniu danych czy współpracy z konkretnym obszarem biznesu. Można też skierować naukę w stronę modeli statystycznych i uczenia maszynowego. Wybór powinien wynikać z zainteresowania zadaniami oraz wymagań roli, którą rozważasz.
Pokażę to na fikcyjnym przykładzie firmy obsługującej dostawy. Najpierw ustalimy, co da się powiedzieć o opóźnieniach. Następnie sprawdzimy, co zmienia próba przewidzenia ich przed zakończeniem dostawy. Liczby są syntetyczne i służą wyjaśnieniu sposobu myślenia. Nie opisują wyników rzeczywistego modelu ani projektu klienta.
Nazwy stanowisk dają orientację, zakres trzeba sprawdzić
W brytyjskim systemie ról data analyst zajmuje się między innymi przygotowaniem, analizą i komunikowaniem danych. Opis data scientist obejmuje statystykę, programowanie, komunikację oraz metody takie jak uczenie maszynowe. To przykład uporządkowania kompetencji w konkretnej organizacji publicznej. Firmy mogą inaczej dzielić podobną pracę.
Nie zakładaj więc, że analityk zawsze kończy na Excelu, a data scientist przez cały dzień trenuje modele. Analityk może pisać rozbudowane programy i prowadzić eksperymenty. Data scientist może spędzać dużo czasu na ustalaniu definicji oraz przygotowaniu danych. Poniższa tabela opisuje dwie odpowiedzialności w naszym przykładzie, a nie sztywne granice obowiązujące na całym rynku.
| Element | Analiza dostaw | Przewidywanie opóźnień |
|---|---|---|
| Pytanie | Gdzie i kiedy pojawiały się opóźnienia? | Które wysyłane teraz paczki mogą się spóźnić? |
| Rezultat | Sprawdzone miary, przekroje i wyjaśnienie ograniczeń | Reguła lub model, ocena błędów i sposób użycia |
| Ważna kontrola | Definicja populacji i zgodność obliczeń | Dostępność informacji w chwili przewidywania |
| Odbiorca | Osoba podejmująca decyzję o procesie | Osoba lub system obsługujący wskazane przypadki |
Wspólny początek: co właściwie oznacza opóźnienie
Firma chce poprawić terminowość. Zanim powstanie raport lub model, trzeba ustalić, z czym porównujemy moment dostarczenia. Czy termin pochodzi z obietnicy dla klienta, wewnętrznego planu czy późniejszej korekty? Czy zmiana terminu po wysyłce ma zastąpić pierwotną wartość? Każda odpowiedź może zmienić etykietę „spóźniona”, więc warto zapisać ją przed obliczeniami.
Potrzebujemy również określić jednostkę obserwacji. Jedno zamówienie może zawierać kilka paczek, a paczka może mieć wiele zdarzeń śledzenia. Jeśli przypadkowo policzysz zdarzenia zamiast dostaw, częściej skanowane przesyłki dostaną większą wagę. Zacząłbym od identyfikatora paczki i sprawdzenia, czy każda zakończona dostawa występuje w analizowanej tabeli dokładnie raz.
Brak czasu dostarczenia nie oznacza automatycznie terminowej przesyłki. Paczka może nadal być w drodze albo jej zdarzenie końcowe nie dotarło do systemu. Trzeba ustalić datę obserwacji oraz zasady traktowania niekompletnych przypadków. Te same decyzje wpływają później na raport i etykiety użyte do oceny prognozy. Dobre czyszczenie danych jest wspólnym fundamentem obu zadań.
Co w tym przykładzie przygotuje analityk danych
Analityk może zacząć od liczby zakończonych dostaw, liczby opóźnień i udziału opóźnionych paczek. Następnie porówna okresy, regiony albo typy usługi. Sprawdzi, czy różnica wynika ze zmiany wyników wewnątrz grup, czy ze zmiany udziału grup w całości. Wzrost ogólnego odsetka nie musi oznaczać, że każda część procesu zaczęła działać gorzej.
Załóżmy, że w naszej małej próbce jest 100 zakończonych dostaw, w tym 10 opóźnionych. Odsetek wynosi 10%. To opis tej próbki. Bez informacji o sposobie jej wyboru nie przypisywałbym takiego wyniku całej firmie. Dodatkowo zapytałbym o pominięte przesyłki i okres, którego dotyczy zestawienie. Sama liczba nie wyjaśnia jeszcze, dlaczego powstały opóźnienia.
Rezultatem może być krótki raport pokazujący skalę zjawiska, miejsca wymagające sprawdzenia i pytania do zespołu operacyjnego. Jeśli w jednym regionie pojawia się problem, analityk powinien rozważyć również różnice w rodzaju usługi czy sposobie rejestrowania zdarzeń. Zależność widoczna w tabeli daje kierunek dalszej pracy. Nie dowodzi automatycznie, że region jest przyczyną problemu.
Co zmienia pytanie o przyszłą dostawę
Teraz firma chce wskazywać zagrożone paczki w chwili wysyłki. Musimy zdefiniować moment przewidywania, dostępne wtedy informacje oraz działanie po otrzymaniu wyniku. Czy pracownik ma sprawdzić trasę? Skontaktować się z przewoźnikiem? Czy ma czas obsłużyć wszystkie wskazania? Bez odpowiedzi można zbudować ocenę ryzyka, której nikt nie potrafi wykorzystać w codziennym procesie.
Data scientist może sprawdzić, czy historyczne dane pozwalają przygotować użyteczną regułę lub model. Najpierw potrzebuje prostego punktu odniesienia, potem sposobu uczciwego porównania. Większa złożoność ma sens dopiero wtedy, gdy poprawia ważny rezultat i da się ją utrzymać. Uruchomienie biblioteki z gotowym algorytmem stanowi niewielką część odpowiedzialności za takie rozwiązanie.
Wynikiem pracy nie powinien być sam plik z modelem. Potrzebne są również zasady przygotowania danych, opis oceny, znane ograniczenia i uzgodniony sposób korzystania z przewidywań. Jeśli później zmieni się źródło lub proces, ktoś musi wiedzieć, jak zauważyć problem i sprawdzić wpływ zmiany. Zakres tej odpowiedzialności warto ustalić między rolami w zespole.
Informacja z przyszłości potrafi zepsuć ocenę
Godzina faktycznego dostarczenia świetnie pomoże rozpoznać opóźnienie po zakończeniu dostawy. Nie jest jednak dostępna przy wysyłce. Gdy użyjesz jej jako cechy modelu przewidującego w tym wcześniejszym momencie, ocena będzie opierała się na informacji, której rozwiązanie nie dostanie podczas normalnego działania. Podobny problem może ukrywać się w statusie nadpisywanym dopiero po zakończeniu procesu.
Dokumentacja scikit-learn o wycieku informacji opisuje to ryzyko oraz konieczność uczenia przekształceń na danych treningowych. Praktycznie sprawdziłbym dla każdej cechy, kiedy jej wartość staje się znana. Wartość obecna dziś w historycznym wierszu mogła nie być dostępna w chwili, którą próbujesz odtworzyć.
W scenariuszu przewidywania przyszłych dostaw ocenę planowałbym na późniejszym okresie niż dane użyte do uczenia. Dokumentacja TimeSeriesSplit wyjaśnia problem uczenia na przyszłości i sprawdzania na przeszłości; porównywalność czasowa jej podziałów zakłada równo rozmieszczone obserwacje. Dla nieregularnych dostaw można wyznaczyć własne granice dat. Trzeba też uwzględnić powiązane paczki i opóźnienie pojawiania się etykiet.
Ocena modelu: 86% trafień może nie wystarczyć
Przyjmijmy syntetyczny zestaw 100 dostaw. Mamy już ich rzeczywisty wynik oraz wcześniejsze, wymyślone na potrzeby ćwiczenia wskazania. To tabela do nauki oceny, bez trenowania modelu. System wskazał 20 paczek jako zagrożone. Osiem z nich rzeczywiście się spóźniło. Dwie kolejne spóźnione paczki nie zostały wskazane.
| Wskazanie | Rzeczywiście spóźnione | Rzeczywiście terminowe | Razem |
|---|---|---|---|
| Zagrożona opóźnieniem | 8 | 12 | 20 |
| Bez wskazania ryzyka | 2 | 78 | 80 |
| Razem | 10 | 90 | 100 |
Z tabeli wynika, że poprawnych decyzji było 86: osiem wykrytych opóźnień i 78 poprawnie niewskazanych terminowych dostaw. Accuracy wynosi więc 86%. Precision odpowiada na pytanie, jaka część wskazań była trafna: 8 podzielone przez 20 daje 40%. Recall mówi, jaką część wszystkich opóźnień znaleźliśmy: 8 podzielone przez 10 daje 80%. Definicje miar opisuje dokumentacja scikit-learn.
Reguła „każda paczka dotrze na czas” uzyskałaby tutaj accuracy 90%, ponieważ 90 dostaw było terminowych. Jednocześnie nie znalazłaby żadnego opóźnienia, więc recall wyniósłby 0%. To pokazuje, dlaczego jedna miara nie wystarcza do wyboru rozwiązania. Nasze wskazania wykrywają osiem problemów, ale kierują do sprawdzenia także 12 terminowych paczek. Trzeba ocenić konsekwencje obu rodzajów błędów.
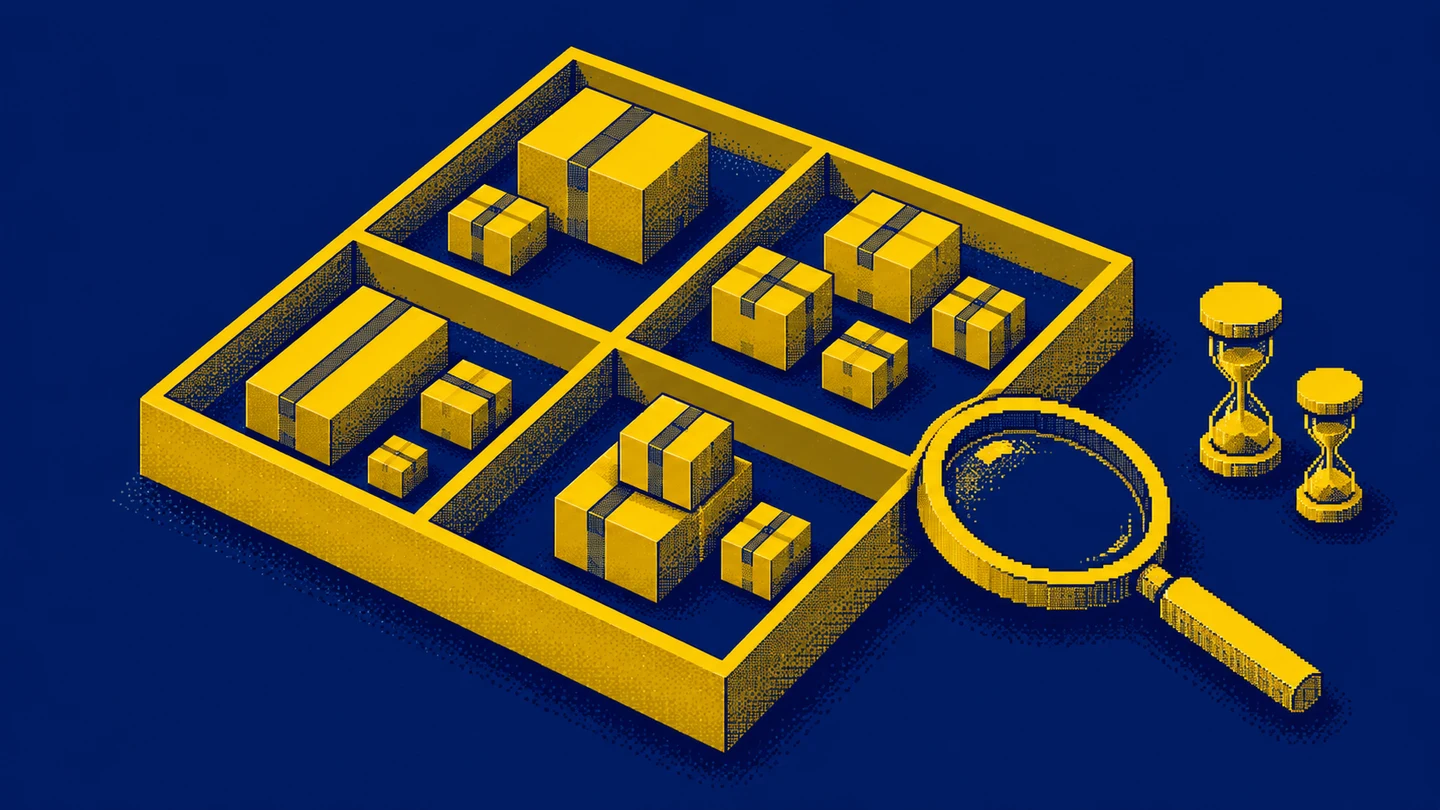
Ilustracja pokazuje ideę rozdzielania wyników na grupy. Liczby do obliczeń znajdują się w tabeli; liczba narysowanych paczek nie odpowiada jej wartościom. Przy omawianiu wyniku z odbiorcą zachowałbym właśnie taki prosty podział na trafne wskazania, fałszywe alarmy, pominięte opóźnienia i poprawnie niewskazane dostawy.
Próg decyzji trzeba powiązać z działaniem
Jeżeli rozwiązanie zwraca ocenę ryzyka, zespół musi zdecydować, od jakiej wartości uruchamia działanie. Niższy próg może zwiększyć liczbę wskazanych przesyłek, ale również obciążenie osób sprawdzających przypadki. W naszym ćwiczeniu wybrano 20 paczek. Nie mamy wyników dla innych progów, więc nie da się z tej tabeli wyliczyć, co przyniesie zmiana ustawienia.
Zapytałbym o możliwość obsłużenia tych 20 przypadków oraz o to, co oznacza przeoczenie dwóch opóźnień. Takie ustalenia prowadzi się razem z osobą odpowiedzialną za proces. Sama wiedza o algorytmie nie rozstrzyga, który kompromis firma może przyjąć. Warto również sprawdzić wyniki w istotnych grupach i kolejnych okresach, bo średnia może ukrywać słabsze działanie w części zastosowań.
Przewidywanie opóźnienia nie dowodzi jeszcze, że proponowany telefon albo zmiana trasy je usunie. Skuteczność interwencji wymaga osobnej oceny. Jeśli pracownicy zaczną działać na podstawie wskazań, zmieni się też proces tworzący późniejsze wyniki. Trzeba rejestrować wykonane działania i uważać, jak interpretuje się kolejne dane. To miejsce, w którym analiza i modelowanie muszą współpracować.
Narzędzia wynikają z rodzaju zadania
Zanim przejdziemy do narzędzi, warto prześledzić zwykłą zmianę po publikacji. Firma dodaje nowy rodzaj usługi dostawy. W raporcie trzeba sprawdzić, czy nowa kategoria została uwzględniona i czy jej termin jest porównywalny z pozostałymi. W rozwiązaniu przewidującym opóźnienia trzeba dodatkowo ustalić, czy model widział podobne przypadki podczas uczenia. Ten sam nowy wiersz w źródle może więc wymagać dwóch różnych ocen.
Nie sprawdzisz jakości prognoz dla nowych paczek natychmiast po wysyłce, bo ich wynik jeszcze nie jest znany. Możesz wcześniej kontrolować kompletność danych, liczbę wskazań i pojawienie się nieznanych kategorii. Ocena trafności przychodzi później, po zakończeniu dostaw i uzyskaniu wiarygodnych etykiet. Ustalenie tego opóźnienia pomaga uniknąć sytuacji, w której zespół uznaje brak alarmu za dowód, że wszystko działa poprawnie.
SQL przyda się do pobierania i łączenia danych w obu rolach. Arkusz pozwoli obejrzeć małą próbkę oraz ręcznie sprawdzić obliczenia. Python lub R mogą służyć analizie, automatyzacji i modelowaniu. Narzędzie BI ułatwi udostępnienie miar odbiorcom. Żadne z tych narzędzi nie określa samodzielnie, jaką rolę pełnisz i jak trudny problem rozwiązujesz.
Dla analityka ważne mogą być model danych, agregacje, definicje wskaźników i projektowanie czytelnych raportów. Przy pracy nad modelami rośnie znaczenie statystyki, walidacji, programowania i rozumienia zachowania algorytmów. Zakres zależy jednak od konkretnego stanowiska. W ogłoszeniu szukałbym przykładów rezultatów, a potem sprawdził, czy wymienione technologie są potrzebne do ich uzyskania.
Wspólna baza pozwala sprawdzić oba kierunki
Na początku poświęciłbym czas na rozumienie tabel: jednostkę wiersza, klucze, braki, duplikaty i łączenia. Potem na agregacje, procenty oraz różnicę między opisem zależności a wyjaśnieniem przyczyny. Te umiejętności wykorzystasz przy raporcie i przy przygotowaniu danych do modelu. Pomaga też zapisywanie kroków tak, żeby wynik można było odtworzyć i sprawdzić.
Jeśli chcesz rozwijać analizę, rozbuduj projekt o pytanie odbiorcy, zestaw miar, przekroje i czytelne uzasadnienie rekomendacji. Jeśli interesuje cię data science, dołóż podstawy prawdopodobieństwa, wnioskowania statystycznego i ocenę modeli na nowych danych. Kolejne tematy dobieraj do tego, czego nie umiesz jeszcze wyjaśnić w projekcie. Nie trzeba jednocześnie opanowywać wszystkich bibliotek, które pojawią się w wyszukiwarce.
Szerszy plan pierwszych kroków znajdziesz w przewodniku jak zostać analitykiem danych. Potraktuj go jako sposób organizowania pracy wokół rezultatów. Ukończenie materiału o danym narzędziu nie mówi jeszcze, czy umiesz samodzielnie zastosować je do nowego pytania. Taką informację daje dopiero własna próba i rozmowa o jej ograniczeniach.
Dwa ćwiczenia na tym samym problemie
Pierwsze ćwiczenie dotyczy analizy. Przygotuj małą syntetyczną tabelę dostaw z identyfikatorem, obiecanym terminem, rzeczywistym zakończeniem i regionem. Dodaj brakującą datę oraz powtórzony identyfikator. Zapisz zasady postępowania z tymi przypadkami, policz terminowość i przedstaw wynik na jednej stronie. Odbiorca powinien wiedzieć, jakie dostawy uwzględniasz i czego z raportu nie da się rozstrzygnąć.
Drugie ćwiczenie dotyczy oceny przewidywań. Zacznij od tabeli 100 wyników z tego artykułu i odtwórz accuracy, precision oraz recall. Następnie rozpisz, jakie informacje byłyby dostępne przy wysyłce i jak podzielisz historię do późniejszego treningu oraz oceny. Dopiero gdy ten plan jest jasny, przejdź do prostej reguły i ewentualnie modelu na odpowiednim zbiorze. Wymyślona tabela nie dowodzi jakości przyszłego rozwiązania.
Po obu próbach zapisz, co najbardziej cię wciągnęło. Doprecyzowywanie definicji, szukanie rozbieżności, projektowanie prezentacji, czy badanie błędów przewidywania? Zauważ też, gdzie potrzebujesz pomocy. Jedno ćwiczenie nie rozstrzyga całej kariery, ale daje konkretną podstawę do wyboru następnego projektu. Możesz zmieniać kierunek wraz z doświadczeniem, bez traktowania poprzedniej nauki jako straconego czasu.
Ofertę oceniaj po odpowiedzialności i wsparciu
Na rozmowie poproś o przykład ostatniego zadania oraz opis tego, co nowa osoba ma samodzielnie oddawać. W roli analitycznej zapytaj o właścicieli miar, źródła danych i sprawdzanie raportów. W roli związanej z modelami dopytaj o sposób oceny, wdrożenie, monitorowanie oraz podział obowiązków z inżynierami. W obu przypadkach ważny jest dostęp do osób rozumiejących proces.
Nie zakładaj z góry, że jeden tytuł gwarantuje wyższe wynagrodzenie, łatwiejszą rekrutację albo mniejsze ryzyko zmiany obowiązków. Porównuj konkretne stanowiska z podobnym poziomem odpowiedzialności i warunkami współpracy. Wskazówki do takiej rozmowy zebrałem w tekście o wadach i warunkach pracy analityka. Nazwa stanowiska jest początkiem rozpoznania, a szczegóły oferty pozwalają ocenić dopasowanie.
Podobnie traktowałbym narzędzia AI. Mogą pomóc przygotować szkic zapytania, kodu albo wyjaśnienia, ale wynik wymaga sprawdzenia na danych i względem celu. Nie wyciągałbym z samego istnienia takich narzędzi obietnicy bezpieczeństwa którejkolwiek kariery. Własną naukę oprzyj na umiejętności zadawania pytań, wykrywania błędów i uzasadniania decyzji, także wtedy, gdy część kodu powstała automatycznie.
Materiał wideo o wyborze ścieżki
Poniżej znajdziesz film towarzyszący porównaniu obu ról. Przy wyborze kierunku nauki zestaw ogólny obraz z własną próbą pracy i aktualnym zakresem interesujących cię stanowisk. Ćwiczenie z dostawami możesz wykorzystać jako punkt wyjścia do takiej rozmowy.
Najważniejsze w pigułce
Czy data scientist to wyższy poziom kariery analityka?
To odmienny zakres pracy, który może częściowo pokrywać się z analizą danych. Obie role mają własne poziomy doświadczenia. O odpowiedzialności mówi konkretny zakres obowiązków, nie sam tytuł.
Czy analityk danych musi znać uczenie maszynowe?
Zależy to od stanowiska. W wielu zadaniach ważniejsze będą definicje miar, SQL, jakość danych i komunikacja. Uczenie maszynowe dodaj, gdy odpowiada na pytanie projektu lub wymaganie docelowej roli.
Jak sprawdzić, która ścieżka bardziej mi odpowiada?
Na tym samym zbiorze przygotuj analizę opisową i ocenę prostych przewidywań. Porównaj, czy bardziej interesują cię definicje i interpretacja procesu, czy projektowanie i sprawdzanie modelu.
