
KajoData / Python
Zmienne, typy danych i operatory w Pythonie: od podstaw do analizy
Dwie zmienne mogą wskazywać tę samą listę, a tekst False może zachować się jak prawda. Pokazuję podstawy Pythona na małym zadaniu z danymi, razem z pułapkami, które psują wynik bez ostrzeżenia.
Kiedy zaczynam pracę z Pythonem, chcę szybko dojść do czegoś użytecznego. Wczytać dane, policzyć wynik, sprawdzić pomysł. Lista wszystkich operatorów wygląda przy tym jak instrukcja obsługi pilota: niby warto przeczytać, ale człowiek od razu szuka przycisku, który robi robotę.
Problem pojawia się wtedy, gdy kod działa, tylko liczy coś innego, niż zakładałem. Liczba okazuje się tekstem. Kopia danych zmienia oryginał. Brak wartości znika razem z prawidłowym zerem. Dlatego pokazuję podstawy na konkretnych decyzjach analitycznych. Chcę wiedzieć, co przechowuję, jak mogę to zmienić i po czym rozpoznam poprawny wynik.
Przykłady są syntetyczne, uruchamiane w Pythonie 3.14.7, bez dodatkowych bibliotek. Każdy blok można wykonać osobno. Komentarze z wynikami pozwalają porównać własny rezultat. Na końcu połączę te elementy w małe podsumowanie zamówień. Nie potrzebujesz jeszcze pandas ani znajomości baz danych.
Zmienna jest nazwą przypisaną do obiektu
Zaczynam od zwykłego przypisania. Nazwa po lewej stronie pozwala później odwołać się do obiektu otrzymanego z wyrażenia po prawej. Sam znak równości nie oznacza tutaj sprawdzania równości. Wydaję instrukcję: od tej chwili pod tą nazwą znajdę ten wynik.
orders_count = 12
previous_count = orders_count
orders_count = orders_count + 3
print(orders_count, previous_count)  # 15 12
Po drugim przypisaniu obie nazwy odnoszą się do liczby dwanaście. Następnie obliczam nową liczbę i przypisuję ją do orders_count. Nazwa previous_count nadal wskazuje wcześniejszy obiekt. To pomaga zrozumieć, dlaczego zapisanie poprzedniego wyniku działa tutaj, a podobny pomysł z listą może mnie zaskoczyć.
Nie deklaruję wcześniej typu nazwy. Mogę później przypisać jej tekst, jednak sam sobie wtedy utrudniam pracę. Jeśli orders_count raz oznacza liczbę zamówień, a chwilę później komunikat o błędzie, każda kolejna operacja musi uwzględniać oba przypadki. Wolę oddzielne nazwy i stabilne znaczenie.
W notebooku dodatkowo pilnuję kolejności wykonania komórek. Wynik może zależeć od przypisania wykonanego dwadzieścia minut wcześniej. Przed uznaniem analizy za gotową restartuję interpreter i uruchamiam całość od początku. Sam fakt, że ostatnia komórka pokazała tabelkę, jeszcze nie mówi mi, czy ktoś inny odtworzy wynik.
Dobra nazwa opisuje również jednostkę
W nazwach używam małych liter i podkreśleń, na przykład delivery_days albo price_cents. Dzięki temu od razu widzę, czego dotyczy liczba. Przy dwóch kolumnach zawierających wartości sto i sto jednostka jest ważniejsza niż elegancja nazwy: sto dni i sto groszy prowadzi do zupełnie innych decyzji.
Python rozróżnia wielkość liter, więc count oraz Count są różnymi nazwami. Nazwa nie może zaczynać się cyfrą ani być zastrzeżonym słowem, takim jak for. Dozwolone są także określone znaki Unicode, w tym polskie litery. Szczegółowe reguły opisuje dokumentacja identyfikatorów.
W projektach zespołowych wybieram zwykle angielskie nazwy zapisane znakami ASCII. To konwencja ułatwiająca współpracę, a nie zakaz polskich nazw w języku. Unikam też nazywania zmiennych list, str czy sum. Taki zapis bywa poprawny składniowo, ale zasłania wbudowane narzędzie, którego za chwilę mogę potrzebować.
Przy czytaniu cudzego kodu najpierw tłumaczę nazwy na pytania. Czy total obejmuje anulowane zamówienia? Czy rate jest ułamkiem, czy procentem? Jeśli odpowiedź wymaga zgadywania, poprawiam nazwę albo dodaję krótki komentarz o znaczeniu biznesowym. Komentarz powtarzający „dodaj trzy” przy dodawaniu trzech raczej mnie nie ratuje.
Typ wybieram według znaczenia danych
Liczbę sztuk zapisuję jako int, pomiar jako float, nazwę produktu jako str, a prosty warunek jako bool. Typ wpływa na dozwolone operacje. Dwa napisy można połączyć, dwie liczby dodać. Ten sam znak plus nie gwarantuje tego samego znaczenia.
print(12 + 3)             # 15
print("12" + "3")         # 123
print(type(12).__name__)  # int
print(type("12").__name__)  # str
print(2 + 3j)            # (2+3j)
Typ complex obsługuje liczby zespolone. W prostym raporcie sprzedaży zwykle go nie potrzebuję, ale warto wiedzieć, że liczby w Pythonie mają więcej odmian niż „całkowite” i „z przecinkiem”. Nie wybieram typu wyłącznie na podstawie wyglądu komórki w arkuszu.
Identyfikator "0012" pozostawiam tekstem, jeśli zera są częścią kodu produktu. Przerobienie go na liczbę może zniszczyć informację potrzebną do połączenia zbiorów. Podobnie numer telefonu składa się z cyfr, ale dodawanie dwóch numerów telefonu nie daje sensownego wyniku analitycznego.
Na początku analizy oglądam kilka wartości i sprawdzam ich typy. Potem sprawdzam przypadki mniej wygodne: puste pole, wyjątkowo długi identyfikator, wartość ujemną. Pięć ładnych rekordów pokazanych na ekranie nie jest dowodem, że reszta danych ma tę samą strukturę. To szczególnie ważne po imporcie pliku przygotowanego ręcznie.
Konwersja wymaga decyzji, co zrobić z błędem
Tekst z formularza albo pliku często trzeba zamienić na liczbę. Robię to jawnie, po sprawdzeniu formatu. Samo wywołanie konwersji nie odpowie za mnie, czy przecinek oznacza separator dziesiętny, czy separator tysięcy.
print(int(" 12 "))      # 12
print(float("12.5"))    # 12.5
print(int(12.9))        # 12
try:
    int("12.5")
except ValueError:
    print("invalid integer")  # invalid integer
try:
    "12" + 3
except TypeError:
    print("incompatible types")  # incompatible types
Obcięcie części ułamkowej przez int może ukryć problem. Jeśli liczba zamówień wynosi dwanaście i pół, najpierw sprawdzam definicję pola. Automatyczna konwersja do dwunastu stworzyłaby pozornie poprawne dane. Dla wartości ujemnych int również obcina w stronę zera, co różni się od zaokrąglenia w dół.
W realnym imporcie zapisuję informację, który wiersz nie przeszedł konwersji. Nie zastępuję wszystkich błędów zerem, bo zero zacznie potem uczestniczyć w średnich i sumach. Zależnie od zadania zatrzymuję przetwarzanie albo oddzielam błędne rekordy do wyjaśnienia. To decyzja o jakości analizy, nie tylko o składni wyjątku.
W ćwiczeniu na końcu przyjmuję bardzo wąski format: liczby całkowite zapisane jako tekst oraz jawne braki. Dzięki temu wiadomo, co przykład obsługuje. Nie udaję, że kilkanaście linijek stanowi uniwersalny czytnik dowolnego eksportu z dowolnego systemu.
None oddziela brak od prawidłowego zera
W tym artykule None oznacza nieznaną wartość. Zero oznacza znany wynik równy zero. Ta różnica decyduje choćby o mianowniku średniej. Jeśli dwa zamówienia mają wartości sto i zero, średnia wynosi pięćdziesiąt. Jeśli drugiej wartości nie znam, nie mogę bez dodatkowego założenia potraktować jej jak zera.
amount = 0
missing = None
print(amount is None)   # False
print(missing is None)  # True
print(bool(amount), bool(missing), bool(""))  # False False False
print(bool("False"), bool("0"))              # True True
Warunek oparty na prawdziwości wartości jest wygodny, ale łączy kilka różnych sytuacji. Pusta lista, pusty tekst, zero i None są fałszywe. Niepusty napis "False" jest prawdziwy. Python sprawdza obecność zawartości, a nie tłumaczy słowa na jego potoczne znaczenie. Reguły są opisane w dokumentacji typów wbudowanych.
Jeśli dostaję tekstową flagę, ustalam dopuszczalne wartości i mapuję je jawnie. Nie przepuszczam jej bezmyślnie przez bool. Przy brakach używam is None, dzięki czemu prawidłowe zero zostaje w danych. Przy pustym tekście osobno decyduję, czy jest brakiem, czy poprawną odpowiedzią.
Lista, krotka, słownik i zbiór rozwiązują inne problemy
Lista przechowuje uporządkowaną sekwencję elementów. Słownik wiąże klucze z wartościami, dlatego dobrze nadaje się do prostego rekordu. Krotka jest sekwencją, której elementów nie podmieniam po utworzeniu. Zbiór pomaga sprawdzać przynależność i usuwać powtórzenia, lecz nie traktuję go jako uporządkowanego raportu.
amounts = [100, 0, 50]
record = {"order_id": "A01", "amount": 100}
point = (10, 20)
statuses = {"paid", "cancelled", "paid"}
print(amounts[0], record["amount"], point[1])  # 100 100 20
print(sorted(statuses))  # ['cancelled', 'paid']
print(list(range(1, 4)))  # [1, 2, 3]
Pierwszy element listy ma indeks zero. Koniec range jest wyłączony, więc zakres od jednego do czterech daje jeden, dwa i trzy. Te dwie drobne zasady odpowiadają za zaskakująco dużo błędów na początku nauki. Sprawdzam je na trzech elementach, zanim puszczę przetwarzanie na większym zbiorze.
Usuwanie duplikatów przez zbiór wymaga uzasadnienia. Dwa zamówienia o tej samej kwocie nadal mogą być dwoma zamówieniami. Zamiana listy kwot na zbiór usunęłaby część sprzedaży. Jeśli interesuje Cię ten problem przy łączeniu tabel, pokazuję go też w artykule o JOIN.
Przypisanie listy nie tworzy jej kopii
Teraz wracam do zmiennych. Lista jest mutowalna: mogę zmienić jej zawartość bez tworzenia nowej listy. Jeśli dwie nazwy odnoszą się do tego samego obiektu, zmiana jest widoczna przez obie. Sama inna nazwa nie zapewnia niezależności danych.
original = [10, 20]
alias = original
snapshot = original.copy()
alias.append(30)
print(original)  # [10, 20, 30]
print(snapshot)  # [10, 20]
print(alias is original, snapshot is original)  # True False
Operator is sprawdza tożsamość obiektu, natomiast == porównuje wartości. Do porównywania kwot używam równości. Nie polegam na tym, czy interpreter akurat przechowuje dwie liczby w tym samym miejscu. Szczegóły tej optymalizacji nie powinny decydować o poprawności raportu.
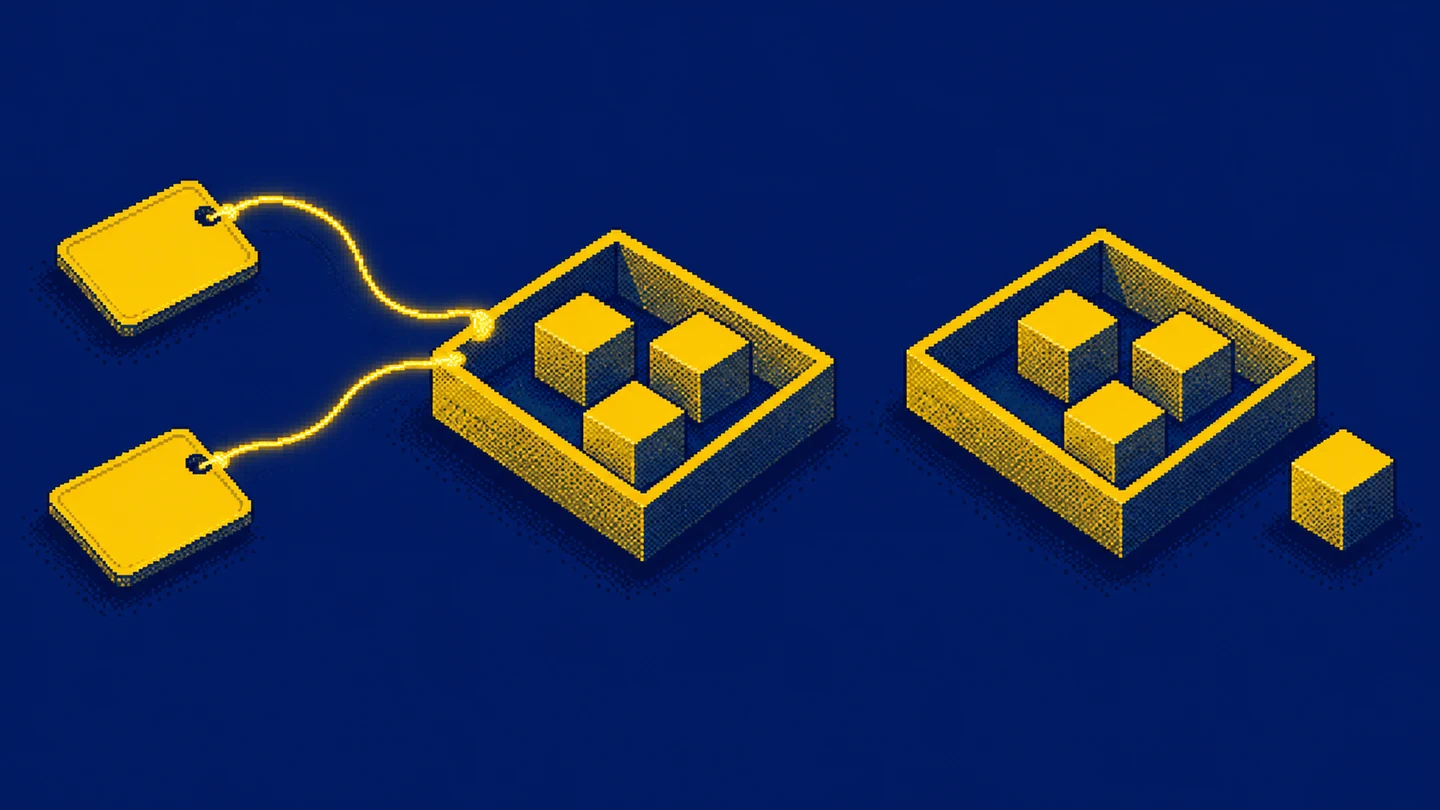
Metoda copy tworzy kopię płytką. Jeśli lista zawiera słowniki, te słowniki nadal mogą być współdzielone. Przy zagnieżdżonych danych rozważam utworzenie nowych rekordów albo odpowiednio dobraną kopię głęboką. Dokumentacja modułu copy wyjaśnia różnicę oraz ograniczenia obu podejść.
Praktyczna kontrola jest prosta: po zmianie wersji roboczej sprawdzam, czy źródło pozostało takie samo. To ważniejsze niż intuicja wynikająca z nazwy backup. Nazwanie listy kopią zapasową nie nadaje jej właściwości kopii zapasowej. Python jest w tej sprawie wyjątkowo mało podatny na marketing.
Operatory czytam razem z nawiasami i typami
Dodawanie, odejmowanie, mnożenie i potęgowanie zapisuję przez +, -, * oraz **. Zwykłe dzielenie dwóch liczb całkowitych daje float. Operator // wykonuje dzielenie z zaokrągleniem w dół, a % zwraca resztę zgodną z regułami tego dzielenia.
print(7 / 2, 7 // 2, 7 % 2)  # 3.5 3 1
print(-7 // 2, -7 % 2)       # -4 1
print(2 + 3 * 4, (2 + 3) * 4)  # 14 20
print(2 ** 3)  # 8
count = 10
count += 5
count -= 3
count *= 2
count /= 4
print(count)  # 6.0
Dla ujemnych wartości dzielenie w dół potrafi zaskoczyć, jeśli ktoś oczekuje samego obcięcia ułamka. Dlatego przy dzieleniu czasu na przedziały najpierw sprawdzam, czy dane mogą być ujemne. Korekta czasu albo zwrot mogą zmienić zakres dopuszczalnych wartości.
Nawiasy stosuję również wtedy, gdy znam kolejność działań. Wzór na zmianę procentową czytelniej pokazuje zamiar, gdy licznik i mianownik są wyraźnie oddzielone. Przy zerowym mianowniku potrzebuję jawnej decyzji: brak wyniku, osobna kategoria czy komunikat. Zastąpienie zera jedynką da działający kod i zmyślony wskaźnik.
Skrócone przypisanie wymaga ostrożności przy obiektach mutowalnych. Dla listy += może zmienić istniejący obiekt, podczas gdy zwykłe dodanie list tworzy nową listę. Reguły operatorów i wyrażeń pomagają rozdzielić te przypadki.
Porównania budują definicję wybranego rekordu
Operatory ==, !=, <, <=, > i >= pozwalają opisać warunek. Zanim go napiszę, ustalam granice. Czy zamówienie dokładnie równe sto zaliczam do dużych? Czy wartość zero jest dozwolona? Odpowiedzi powinny być widoczne w kodzie i w opisie raportu.
amount = 100
status = "paid"
print(amount >= 100 and status == "paid")  # True
print(0 <= amount < 100)                   # False
print(status in {"paid", "shipped"})       # True
print(not (status == "cancelled"))         # True
print("" or "unknown")                    # unknown
and oraz or stosują krótkie spięcie: drugi operand jest oceniany tylko wtedy, gdy jest potrzebny. Co więcej, zwracają jeden z operandów, niekoniecznie True lub False. To wyjaśnia ostatnią linię. Taki zapis bywa wygodny dla tekstu zastępczego, ale przy liczbach może przypadkiem zastąpić prawidłowe zero.
W złożonym filtrze rozbijam warunki na nazwane części. Wolę widzieć osobno poprawny status i dopuszczalną kwotę niż odgadywać sens długiego ciągu operatorów. Dzięki temu łatwiej sprawdzić przypadek graniczny i wyjaśnić innemu człowiekowi, dlaczego konkretny rekord trafił do wyniku.
Float jest przybliżeniem, a formatowanie zmienia widok
Liczby zmiennoprzecinkowe są przydatne w analizie pomiarów i obliczeniach numerycznych. Nie każdą dziesiętną wartość zapisują jednak dokładnie. Opis arytmetyki float pokazuje, skąd bierze się różnica między zapisem dziesiętnym a reprezentacją binarną.
from decimal import Decimal
from math import isclose
print(0.1 + 0.2 == 0.3)       # False
print(isclose(0.1 + 0.2, 0.3))  # True
print(Decimal("0.1") + Decimal("0.2"))  # 0.3
print(f"{0.1 + 0.2:.2f}")    # 0.30
Formatowanie do dwóch miejsc zmienia prezentację, nie naprawia reprezentacji liczby. Przy porównywaniu pomiarów dobieram tolerancję do skali problemu. Przy kwotach rozważam całkowite jednostki najmniejszej waluty albo Decimal z wejściem tekstowym. Sam wybór Decimal nie ustala reguł zaokrąglania ani biznesowej definicji kwoty.
W naszym ćwiczeniu użyję groszy jako liczb całkowitych. Dzięki temu sumowanie pozostaje proste, a jednostka jest jawna. To świadome ograniczenie przykładu. Jeśli pojawią się kursy walut albo podział kosztu między wiele pozycji, trzeba dodatkowo zaprojektować zaokrąglanie i sposób rozliczenia pozostałej różnicy.
Zanim połączę elementy, ustalam kontrakt wejścia
Mały program również potrzebuje opisu danych. W naszym zadaniu jeden słownik ma oznaczać jedno zamówienie, identyfikator jest tekstem, status pochodzi z ustalonej listy, a kwota jest liczbą całkowitą groszy zapisaną jako tekst albo brakiem. Te założenia zapisuję przed obliczeniami. Dzięki temu łatwiej rozpoznać rekord, którego program w obecnej wersji nie obsługuje.
Osobno sprawdzam unikalność identyfikatora. Dwie identyczne kwoty są dopuszczalne, ale dwa wiersze z tym samym numerem zamówienia wymagają wyjaśnienia. Mogą oznaczać błąd eksportu, historię zmian albo pozycje zamówienia. Każde z tych wyjaśnień prowadzi do innego rozwiązania. Automatyczne usunięcie powtórzenia przed sprawdzeniem znaczenia wiersza może usunąć prawidłowe dane.
Ustalam także, czy kwoty ujemne są legalne. Zwrot i omyłkowo wpisany minus wyglądają tak samo dla typu całkowitego. Typ potwierdza możliwość wykonania działania, lecz nie potwierdza biznesowej poprawności wartości. Podobnie opłacone zamówienie o kwocie zero może być próbką, prezentem albo błędem. W ćwiczeniu świadomie uznaję je za poprawne.
Gdy wynik mnie zaskakuje, zatrzymuję się na pierwszym rekordzie, dla którego oczekiwanie różni się od obliczenia. Oglądam surową wartość, jej typ, warunek wyboru i wkład do sumy. Nie zaczynam od dopisywania kolejnych konwersji w losowych miejscach. Taka próba naprawy potrafi sprawić, że program przestanie zgłaszać błąd, ale trudniej będzie ustalić, jakie dane naprawdę przetworzył.
Ćwiczenie: policz znane wartości opłaconych zamówień
Mam cztery syntetyczne rekordy. Uwzględniam tylko opłacone zamówienia z podaną kwotą. Zero jest poprawną kwotą. Brak kwoty ma być widoczny w osobnym liczniku. Zanim uruchomię program, zapisuję oczekiwanie: dwa znane zamówienia, suma dwanaście tysięcy groszy i jeden brak.
rows = [
    {"id": "A01", "status": "paid", "amount_cents": "12000"},
    {"id": "A02", "status": "paid", "amount_cents": "0"},
    {"id": "A03", "status": "cancelled", "amount_cents": "5000"},
    {"id": "A04", "status": "paid", "amount_cents": None},
]
total_cents = 0
known_count = 0
missing_count = 0
for row in rows:
    if row["status"] != "paid":
        continue
    raw_amount = row["amount_cents"]
    if raw_amount is None:
        missing_count += 1
        continue
    total_cents += int(raw_amount)
    known_count += 1
average_cents = total_cents / known_count if known_count else None
print(total_cents, known_count, missing_count, average_cents)
# 12000 2 1 6000.0
Pętla bierze kolejne słowniki z listy. continue przechodzi do następnego rekordu. Wcięcia określają, które instrukcje należą do warunku i pętli. Średnia dotyczy wyłącznie znanych kwot opłaconych zamówień. Nie nazywam jej średnią wszystkich zamówień, bo pominięty brak ogranicza interpretację.
Teraz zmień wszystkie statusy na anulowane. Powinno wyjść zero sumy, zero znanych zamówień i średnia None. Potem przywróć dane i dodaj drugie opłacone zamówienie z kwotą "12000". Suma ma wzrosnąć do dwudziestu czterech tysięcy, a licznik do trzech. Powtórzona kwota pozostaje osobnym rekordem.
Na końcu wpisz "brak" zamiast liczby. Program zgłosi ValueError, bo ten format nie należy do przyjętych danych. To dobry moment, żeby zaprojektować raport błędnych wierszy. Sprawdzanie takich zmian daje mi więcej niż wielokrotne uruchamianie jednego szczęśliwego przykładu.
Jeśli chcesz przenieść podobny sposób myślenia do raportów, zobacz histogram w SQL. Narzędzie się zmienia, ale pytania o jednostkę, brak wartości i znaczenie jednego wiersza zostają. Właśnie od tych pytań zaczynam analizę, zanim zachwycę się zwięzłością kodu.
Najważniejsze w pigułce
Czy muszę deklarować typ zmiennej w Pythonie?
Nie. Typ ma obiekt, do którego przypisujesz nazwę. Możesz później przypisać tej nazwie obiekt innego typu, ale w analizie zwykle utrudnia to zrozumienie kodu.
Dlaczego zmiana jednej listy zmienia też drugą zmienną?
Przypisanie drugiej nazwy do listy nie tworzy kopii. Obie nazwy wskazują ten sam obiekt. Metoda copy tworzy nową listę zewnętrzną, lecz zagnieżdżone obiekty nadal mogą być wspólne.
Czy None, zero i pusty tekst oznaczają to samo?
Nie. None może oznaczać brak wartości, zero jest liczbą, a pusty tekst jest napisem. Wszystkie są fałszywe w warunku, dlatego brak danych sprawdzam jawnie przez is None.
