
KajoData / Praca i rozwój
Data cleaning: jak poprawiać dane bez usuwania ich znaczenia
Przechodzę od surowej tabeli do danych gotowych do analizy. Wyjaśniam, kiedy usuwać rekord, kiedy zostawić brak i jak sprawdzić, co zmieniła każda operacja.
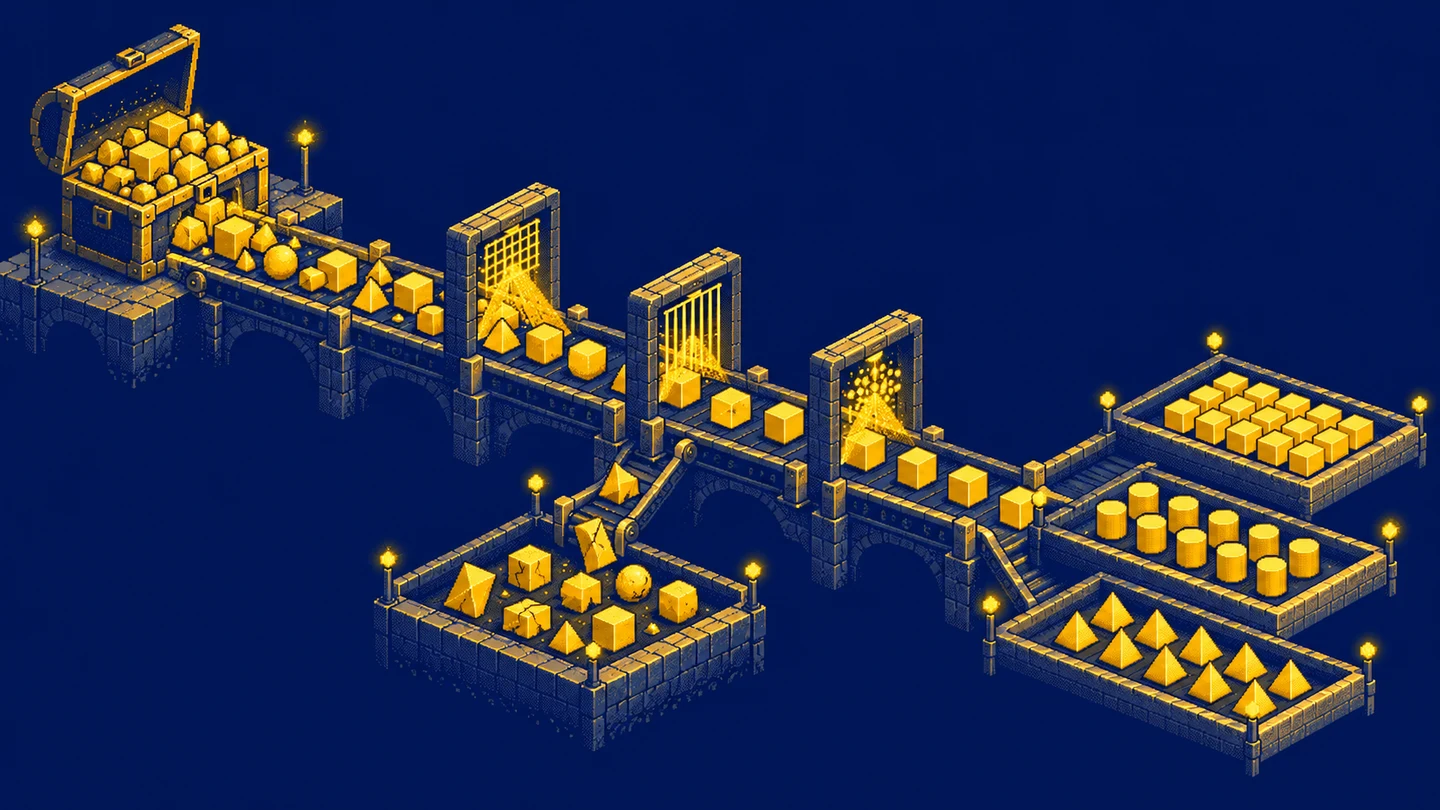
Wykres potrafi wyglądać świetnie nawet wtedy, gdy policzono na nim dwa razy to samo zamówienie. Dlatego przy nowym zbiorze zaczynam od pytań o rekordy, braki i znaczenie kolumn. Czyszczenie danych, czyli data cleaning, obejmuje zarówno operacje techniczne, jak i decyzje o tym, co wolno zmienić. Sam przycisk „usuń duplikaty” nie zna definicji zamówienia w Twojej firmie.
Nie przypisuję temu etapowi uniwersalnego procentu czasu pracy analityka. Zależy on od źródła, procesu i zadania. Wolę pokazać, co konkretnie trzeba ustalić, zanim wynik trafi do odbiorcy. W tym poradniku używam małych danych syntetycznych i opisuję rachunki, które można prześledzić bez uruchamiania programu.
Ustal cel i zachowaj dane wejściowe
Załóżmy, że przygotowujesz zestawienie wartości zamówień według miasta. Zanim poprawisz choć jedną komórkę, zapisz zakres dat, wybraną wersję eksportu i znaczenie kwoty. Czy obejmuje podatek, zwroty i anulowania? Czy jeden wiersz oznacza zamówienie, jego pozycję, czy zdarzenie zmiany statusu? Bez tych odpowiedzi nie wiesz jeszcze, które powtórzenia są błędami.
Ja pracuję na przekształceniach prowadzących od zachowanego wejścia do wyniku. Dzięki temu można odtworzyć raport i sprawdzić, na którym kroku zmieniła się liczba rekordów. Ręczna poprawka w jedynej kopii pliku utrudnia takie wyjaśnienie. Zostawienie źródła nie oznacza publikowania go ani powielania poza uzgodnionym miejscem pracy.
Na początek zapisuję liczebność tabeli, liczbę unikalnych kluczy, zakres dat i sumę wartości, jeżeli ma ona porównywalną jednostkę. Te liczby są punktem odniesienia. Nie każda operacja musi zachować sumę, ale każda zmiana sumy powinna mieć powód. Gdy po usunięciu spacji maleje przychód, chcę wiedzieć, co jeszcze wydarzyło się w tym kroku.
Profilowanie pokazuje miejsca do sprawdzenia
Przeglądam typy kolumn, braki, różne wartości kategorii i podejrzane zakresy. W Power Query pomagają w tym Column quality, Column distribution i Column profile. Dokumentacja Microsoft zwraca uwagę, że domyślnie profilowanie opiera się na pierwszych 1000 wierszy; można przełączyć je na cały zbiór. Podgląd próbki nie dowodzi jakości pozostałych rekordów.
Profil traktuję jako listę tropów. Liczba różnych miast może być większa od oczekiwanej z powodu spacji, literówek albo rzeczywiście szerszego obszaru sprzedaży. Ujemna kwota może oznaczać zwrot, korektę lub błąd. Sam typ liczbowy nie rozstrzyga, czy wartość ma sens. Potrzebuję reguły biznesowej i informacji o tym, jak powstaje rekord.
Warto zacząć od pól wpływających na odpowiedź. Jeśli raport grupuje po mieście i sumuje kwotę, te dwie kolumny oraz klucz wymagają szczególnej uwagi. Pełny audyt wszystkich pól może być osobnym zadaniem. Określenie zakresu pomaga uczciwie opisać, co sprawdzono, a czego ten konkretny raport jeszcze nie potwierdza.
Duplikat rozpoznajesz po kluczu i znaczeniu
Oto syntetyczny eksport, w którym jeden wiersz ma oznaczać całe zamówienie:
| Zamówienie | Miasto | Kwota |
|---|---|---|
| A | Warszawa | 100 |
| A | Warszawa | 100 |
| B | warszawa | brak |
| C | Kraków | 20 |
| D | Kraków | 900 |
Załóżmy, że właściciel źródła potwierdził ponowne wysłanie tego samego rekordu A. Usunięcie jednej kopii jest wtedy uzasadnione. Suma znanych kwot spada z 1120 do 1020, a liczba wierszy z pięciu do czterech. Różnica 100 ma konkretny powód, który potrafię wskazać w danych. Nie jest efektem ogólnego „porządkowania tabeli”.
Gdyby wiersze były pozycjami zamówienia, dwa rekordy A mogłyby być prawidłowe. Klucz mógłby wymagać numeru pozycji. Gdyby były kolejnymi stanami zamówienia, potrzebna byłaby reguła wyboru aktualnego stanu. Nie wybieram pierwszego rekordu bez ustalonego porządku i nie uznaję najnowszej daty za automatyczne rozwiązanie każdej historii zmian.
W pandas drop_duplicates pozwala określić kolumny przez subset i sposób zachowania powtórzeń przez keep; indeks nie bierze udziału w porównaniu. Opisuje to dokumentacja metody. Funkcja realizuje wybraną regułę, ale nie ustala, które kolumny stanowią poprawny biznesowy klucz.
Brak wartości zachowuje informację
W zamówieniu B nie znam kwoty. Wstawienie zera sprawiłoby, że tabela wyglądałaby na kompletną, ale jednocześnie stwierdzałoby, że zamówienie nie miało wartości. Tego nie wiemy. Dla przykładu pokazuję więc znaną sumę 1020, cztery zamówienia i jeden brak kwoty. Nie nazywam tej sumy pełnym przychodem wszystkich zamówień.
Przy średniej problem staje się jeszcze wyraźniejszy. Trzy znane kwoty po deduplikacji to 100, 20 i 900, czyli średnio 340. Gdyby brak zastąpić zerem i dzielić przez cztery, wynik wyniósłby 255. Każdy rachunek jest prosty; spór dotyczy założenia, jakie wprowadziliśmy do danych. Odbiorca powinien je zobaczyć, zamiast dostać pozornie jednoznaczną średnią.
Braki rozróżniam także według znaczenia: wartość nieznana, pole niedotyczące rekordu, oczekiwanie na aktualizację albo błąd integracji. Dokumentacja braków w pandas opisuje reprezentacje i operacje zależne od typu danych. Nie zakładam, że pusty tekst, zero i znacznik braku są zamienne. Imputacja wymaga uzasadnienia oraz oznaczenia, które wartości zostały oszacowane.
Format, słownik i jednostka to odrębne decyzje
„Warszawa” i „warszawa” mogą zostać przypisane do jednej etykiety, jeśli taka jest uzgodniona reguła. W przykładzie zmienia się liczba kategorii, a kwoty pozostają takie same. Przy niejednoznacznych nazwach potrzebuję słownika i identyfikatora, nie tylko zmiany wielkości liter. Skrót może oznaczać różne miejsca, więc automatyczne rozwinięcie wymaga ostrożności.
Identyfikatory często powinny pozostać tekstem. Kod z początkowym zerem może stracić znaczenie po zamianie na liczbę. Z kolei kwota zapisana jako tekst wymaga właściwego odczytu separatorów. Zapis 1,234 może być rozumiany inaczej w różnych ustawieniach regionalnych. Najpierw ustalam format źródła, potem przekształcam wartości i osobno kontroluję błędy konwersji.
Tak samo traktuję daty, waluty i jednostki masy. Ten sam wygląd komórki nie gwarantuje tego samego typu ani znaczenia. Ujednolicenie waluty wymaga kursu, daty i reguły przeliczenia; zmiana nazwy nagłówka nie wystarczy. Jeśli nie mam podstaw do przeliczenia, rozdzielam wartości według jednostki, zamiast dodawać je do jednej sumy.
Nie przebudowuj tabeli tylko dlatego, że zawiera dane klienta
W starszym podejściu łatwo pomylić czyszczenie z nakazem normalizacji każdej tabeli. Obecność nazwy klienta obok zamówienia sama w sobie nie dowodzi błędu. Może być celowym eksportem analitycznym, historycznym stanem danych albo częścią modelu przygotowanego pod raport. Trzeba ustalić przeznaczenie i reguły aktualizacji.
W modelowaniu analitycznym występują tabele faktów i wymiarów, a wybór struktury zależy od sposobu analizy. Wytyczne Microsoft dotyczące schematu gwiazdy pokazują taki kontekst dla Power BI. Ujednolicenie etykiet, skalowanie liczb i normalizacja relacyjna to różne operacje. Warto nazywać je precyzyjnie, aby odbiorca wiedział, co faktycznie zmieniono.
Ja najpierw sprawdzam, czy atrybuty opisują właściwy moment i czy łączenie zachowuje oczekiwaną liczność. Jeśli tabela klientów ma kilka wersji osoby, zwykłe połączenie po samym identyfikatorze może zwielokrotnić zamówienia. Rozwiązanie wymaga reguły czasowej lub wyboru właściwej wersji. Samo przeniesienie nazw do osobnej tabeli nie zapewnia poprawnego wyniku.
Nietypowa wartość potrzebuje wyjaśnienia
Kwota 900 w naszym przykładzie jest dużo większa od 100 i 20. To powód do sprawdzenia, a nie automatycznego usunięcia. Mogła oznaczać duży zakup, inną jednostkę albo pomyłkę. Jeśli potwierdzimy, że jest poprawna, jej usunięcie zaniży opis rzeczywistej sprzedaży. Jeśli jest błędem, korekta potrzebuje podstawy i śladu decyzji.
NIST rozróżnia wykrywanie wartości odstających i sposób postępowania z nimi. Potwierdzony błąd można poprawić lub wyłączyć; niewyjaśniona nietypowość może wymagać innej metody analizy. Nie ma uczciwej ogólnej reguły „statystycy nigdy nie usuwają anomalii”. Równie niewłaściwe jest usuwanie wszystkiego poza arbitralnym progiem, bo wykres ma wtedy przyjemniejszy kształt.
Przy niepewności pokazuję skalę problemu i wpływ na wynik. Można przedstawić analizę z rekordem oraz wariant po jego wyłączeniu, jasno nazywając ten drugi wariant. Odbiorca widzi wtedy konsekwencje, a osoba odpowiedzialna za źródło ma konkretne pytanie do rozstrzygnięcia. Sam status „do sprawdzenia” bywa bardziej użyteczny niż cicha poprawka.
Kontroluj rezultat po połączeniu źródeł
Czyszczenie jednej tabeli nie kończy pracy. Dodanie słownika miast lub klientów może powielić albo zgubić rekordy. Sprawdzam więc liczebność przed i po połączeniu, brak dopasowania oraz sumę miary, która powinna pozostać niezmieniona. Jeśli słownik ma być jednoznaczny, kilka wierszy dla jednego klucza wymaga wyjaśnienia przed użyciem go w raporcie.
W pandas parametr validate w merge umożliwia kontrolę oczekiwanej liczności relacji, a indicator pomaga rozróżnić pochodzenie dopasowań. Dokumentacja merge ostrzega też, że brakujące klucze mogą dopasowywać się do siebie, inaczej niż przy typowym zachowaniu SQL. Nie przenoszę reguł jednego narzędzia na inne bez sprawdzenia.
Dla naszego przykładu oczekiwałbym czterech zamówień po przypisaniu etykiet miast i nadal 1020 znanej wartości. Jeśli otrzymam pięć rekordów, wracam do słownika. Jeśli zniknie B, sprawdzam, czy brak kwoty albo niepasujący klucz nie został przypadkowo użyty jako powód odrzucenia całego zamówienia. Te dwie sytuacje wymagają innych reguł naprawy.
Zapisz reguły i warunki publikacji
Dobra notatka z przekształceń mówi, co zmieniono i dlaczego: usunięto jedną potwierdzoną kopię A, ujednolicono etykietę miasta, pozostawiono brak kwoty B oraz skierowano D do wyjaśnienia. Przy każdej operacji chcę znać liczbę dotkniętych rekordów. Dzięki temu kolejny eksport da się porównać z poprzednim bez odtwarzania decyzji z pamięci.
Przed publikacją ustalam z odbiorcą, czy nierozstrzygnięty problem blokuje cały raport, jedną miarę czy tylko określony segment. Brak kwoty nie musi blokować zestawienia liczby zamówień. Może natomiast blokować twierdzenie o pełnym przychodzie. Takie rozdzielenie pozwala dostarczyć użyteczny wynik bez ukrywania ograniczenia i bez udawania, że wszystkie kolumny osiągnęły idealną jakość.
Reguły można później automatyzować. Automatyzacja jest szczególnie przydatna do powtarzalnych kontroli, konwersji i sygnalizowania nowych wyjątków. Nie zakładam jednak, że reguła pozostaje właściwa po zmianie procesu źródłowego. Gdy pojawia się nowy status, jednostka albo wersja eksportu, potrzebuję przeglądu definicji. Powtarzalność operacji i aktualność jej sensu to dwa osobne warunki.
Uważaj na kolejność operacji
Załóżmy, że dwa rekordy różnią się wyłącznie spacją na końcu identyfikatora. Jeśli szukasz duplikatów przed uporządkowaniem klucza, możesz ich nie zauważyć. Jeśli najpierw bez uzasadnienia usuniesz wszystkie różnice z klucza, możesz z kolei połączyć dwa odrębne oznaczenia. Kolejność ma znaczenie, ale reguła zmiany klucza musi wynikać z definicji źródła.
Dlatego przy takich korektach zachowuję możliwość porównania wartości pierwotnej i wynikowej w uzgodnionym środowisku pracy. Chcę wiedzieć, które identyfikatory zostały scalone do jednego. Oczekiwane ujednolicenie i przypadkowa kolizja mogą dawać podobny efekt liczbowy. Sam spadek liczby różnych kluczy nie mówi jeszcze, czy zmiana była poprawna.
Inny przykład dotyczy filtrowania. Jeśli przed kontrolą braków odrzucisz wszystkie rekordy bez kwoty, profil pozostałej tabeli pokaże pełne dane. Odbiorca może uznać, że źródło było kompletne, choć zniknęła część zamówień. Liczbę odrzuceń i przyczyny trzeba więc liczyć względem wejścia, a nie tylko końcowego wyniku. Raport z jakości nie powinien ukrywać własnego mianownika.
Podobny problem występuje przy łączeniu i sumowaniu. Suma po joinie może już zawierać powielenia, więc nie nadaje się automatycznie na nowy punkt odniesienia. Zachowaj kontrolę z etapu sprzed połączenia. W naszym przykładzie znana wartość 1020 jest wyprowadzona z potwierdzonych zamówień; właśnie z nią porównujesz wynik wzbogacenia słownikiem, zamiast porównywać dwa kolejne błędne warianty.
Oddziel naprawę źródła od obejścia w raporcie
Gdy regularnie pojawia się ta sama literówka miasta, słownik w raporcie może pomóc dostarczyć wynik. Warto jednak ustalić, czy da się poprawić sposób wprowadzania danych albo eksport. Inaczej każda kolejna analiza musi odtwarzać to samo obejście, a różne osoby mogą przyjąć różne mapowania. Przyczyna zostaje w procesie, nawet jeśli jeden wykres już wygląda dobrze.
Ja opisuję wtedy dwa działania: co robimy teraz z istniejącymi rekordami oraz co ma zapobiec następnym błędom. Nie każda usterka wymaga przebudowy systemu, ale warto znać koszt stałego ręcznego poprawiania. Powtarzalna drobna niezgodność może być większym problemem operacyjnym niż jednorazowy spektakularny błąd, jeśli regularnie angażuje kilka zespołów.
Przy zwrocie informacji właścicielowi źródła pokazuję niewielki przykład i regułę, której oczekuję. „Miasta są brudne” jest trudne do wykonania. „Dla tego identyfikatora mamy dwie sprzeczne etykiety; która jest właściwa i od kiedy?” pozwala udzielić odpowiedzi. To część pracy analitycznej równie konkretna jak wybór funkcji, ponieważ bez tej odpowiedzi przekształcenie byłoby tylko zgadywaniem.
Ćwiczenie: obroń każdą zmianę
Weź tabelę z tego tekstu i przygotuj dwie listy: operacje potwierdzone oraz pytania wymagające odpowiedzi właściciela danych. Napisz, dlaczego można usunąć kopię A, a nie można od razu usunąć D. Wyjaśnij też, co dokładnie opisuje suma 1020 i dlaczego nie nazywasz jej kompletnym wynikiem wszystkich czterech zamówień.
Potem zmień założenie: niech wiersz oznacza pozycję zamówienia. Sprawdź, które wcześniejsze decyzje przestają być uzasadnione. Takie ćwiczenie uczy rozpoznawania zależności między strukturą danych a czyszczeniem. Nie chodzi o zapamiętanie pięciu przycisków, lecz o umiejętność wyjaśnienia, dlaczego konkretna operacja zachowuje albo zmienia informację potrzebną do odpowiedzi.
Jeśli chcesz rozszerzyć warsztat, przeczytaj poradnik o etapach czyszczenia danych oraz wprowadzenie do Power Query. Z tego artykułu zabrałbym jeden nawyk: po każdej zmianie porównaj wynik ze źródłem i zapisz powód różnicy. To właśnie pozwala oddać raport, którego liczby da się później obronić.
Przy kolejnym eksporcie sprawdź również rekordy, które wcześniej trafiły do wyjaśnienia. Poprawka kwoty B albo potwierdzenie zamówienia D może zmienić opis ograniczeń raportu. Nie zostawiaj dawnego ostrzeżenia automatycznie i nie usuwaj go tylko dlatego, że uruchomienie przekształceń zakończyło się bez błędu. Stan reguł oraz stan konkretnych wyjątków wymagają osobnego odczytu z aktualnych danych.
Film o czyszczeniu danych
Zachowuję film związany z oryginalnym wpisem. Tekst powyżej rozwija temat na osobnym przykładzie syntetycznym.
Najważniejsze w pigułce
Czy każdy duplikat identyfikatora trzeba usunąć?
Nie. Najpierw określ znaczenie wiersza i pełny klucz. Kilka pozycji tego samego zamówienia albo historia zmian może być prawidłową strukturą.
Czy brakujące liczby mogę zawsze zastąpić zerem?
Zero ma konkretne znaczenie, a brak może oznaczać nieznaną wartość, awarię albo pole, które nie dotyczy rekordu. Zastąpienie wymaga reguły zgodnej z celem analizy.
Czy wartości odstające trzeba usuwać przed raportowaniem?
Najpierw ustal przyczynę. Błąd można poprawić lub wyłączyć według jawnej reguły, ale nietypowe poprawne zdarzenie może być najważniejszą informacją w danych.
Przy pracy nad artykułem użyto w zautomatyzowany sposób sztucznej inteligencji. Jeśli też chcesz tak umieć, sprawdź ten projekt.
